Controlli di integrità di schemi e identità
I controlli di integrità degli schemi e delle identità analizzano gli schemi e gli spazi dei nomi delle identità per individuare best practice mancanti e configurazioni errate che causano una risoluzione incompleta delle identità, conteggi di profili gonfiati e attivazione imprecisa.
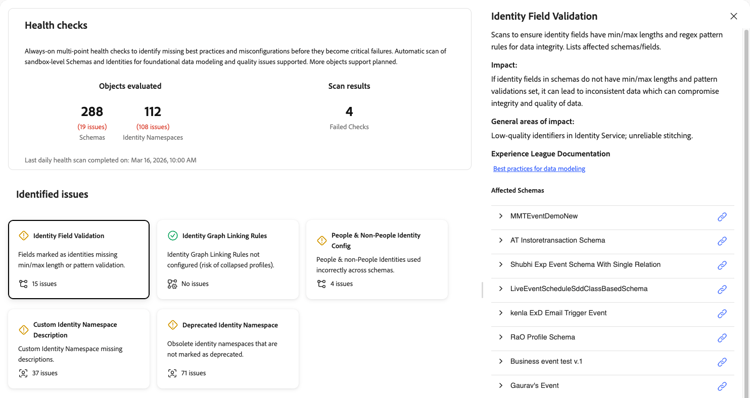
Convalida campo identità identity-field-validation
Esegue la scansione per garantire che i campi di identità abbiano vincoli di lunghezza minima e massima e regole di pattern regex per l’integrità dei dati.
Quando selezioni la scheda Convalida campo identità, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: esegue la scansione per verificare che i campi di identità abbiano lunghezze minime/massime e regole di pattern regex per l’integrità dei dati. Elenca gli schemi e i campi interessati.
- Impatto: se i campi di identità negli schemi non hanno lunghezza minima/massima e le convalide dei pattern impostate, si possono verificare dati incoerenti che possono compromettere l’integrità e la qualità dei dati.
- Aree generali di impatto: identificatori di bassa qualità in Identity Service; unione inaffidabile.
- Documentazione di Experience League: collegamento alle best practice per la modellazione dei dati.
- Schemi interessati: elenco di schemi interessati, ciascuno con un modulo di espansione per visualizzare ulteriori dettagli e un collegamento per aprire lo schema.
Per ulteriori informazioni, vedere i suggerimenti sull’integrità dei dati nella documentazione sulle best practice per gli schemi.
Regole di collegamento del grafo identità identity-graph-linking-rules
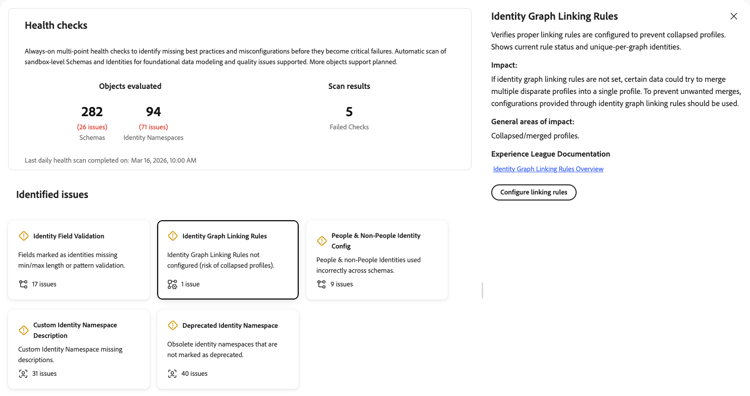
Verifica che le regole di collegamento del grafo delle identità siano configurate per una sandbox per impedire la compressione dei profili.
Quando selezioni la scheda Regole di collegamento del grafico delle identità, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: verifica che siano configurate regole di collegamento appropriate per impedire la compressione dei profili. Mostra lo stato della regola corrente e identità univoche per grafico.
- Impatto: se non sono impostate le regole di collegamento del grafico delle identità, alcuni dati potrebbero tentare di unire più profili diversi in un unico profilo. Per evitare unioni indesiderate, è necessario utilizzare le configurazioni fornite tramite le regole di collegamento del grafico delle identità.
- Aree di impatto generali: profili compressi o uniti.
- Documentazione di Experience League: un collegamento alla panoramica delle regole di collegamento del grafico delle identità per ulteriori informazioni.
- Configura regole di collegamento: quando il controllo non riesce, viene visualizzato un pulsante che consente di configurare le regole di collegamento direttamente dal pannello.
Per ulteriori informazioni, consulta la panoramica delle regole di collegamento del grafo delle identità e la guida all’implementazione.
Configurazione dell’identità di persone e non persone people-non-people-identity
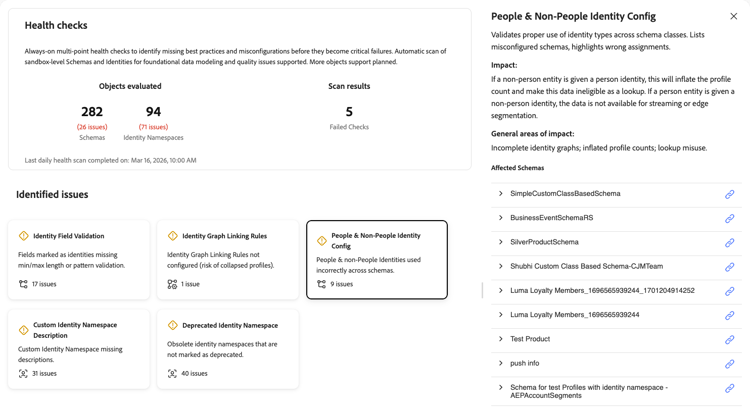
Convalida l’uso corretto dei tipi di identità persone e non persone nelle classi dello schema.
Quando selezioni la scheda di configurazione Persone e non-Persone, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: convalida l’uso corretto dei tipi di identità tra le classi dello schema. Elenca gli schemi non configurati correttamente ed evidenzia le assegnazioni errate.
- Impatto: se a un’entità non-people viene assegnata un’identità di persona, il conteggio dei profili verrà gonfiato e i dati non saranno idonei per la ricerca. Se a un’entità persona viene assegnata un’identità non-people, i dati non sono disponibili per lo streaming o la segmentazione Edge.
- Aree di impatto generali: grafici di identità incompleti; conteggi di profili gonfiati; utilizzo errato della ricerca.
- Schemi interessati: elenco di schemi con problemi. Espandi una riga di schema per visualizzare il percorso, il nome dell’identità e il tipo di schema per ogni configurazione errata. Utilizza l’icona del collegamento per aprire lo schema.
Per ulteriori informazioni, consulta la documentazione sul tipo di identità e le best practice per gli schemi.
Descrizione dello spazio dei nomi dell’identità personalizzata namespace-missing-description
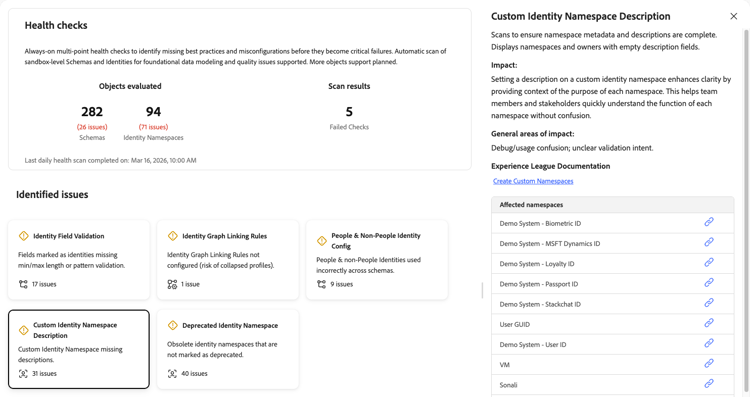
Esegue la scansione per verificare che i metadati e le descrizioni dello spazio dei nomi delle identità personalizzate siano completi.
Quando selezioni la scheda Descrizione dello spazio dei nomi dell’identità personalizzato, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: esegue la scansione per verificare che i metadati e le descrizioni dello spazio dei nomi siano completi. Visualizza spazi dei nomi e proprietari con campi di descrizione vuoti.
- Impatto: l’impostazione di una descrizione in uno spazio dei nomi di identità personalizzato migliora la chiarezza fornendo il contesto dello scopo di ogni spazio dei nomi. In questo modo i membri del team e le parti interessate possono comprendere rapidamente la funzione di ogni spazio dei nomi senza confusione.
- Aree di impatto generali: confusione di debug o di utilizzo; intento di convalida non chiaro.
- Documentazione di Experience League: collegamento per la creazione di spazi dei nomi personalizzati per ulteriori informazioni.
- Spazi dei nomi interessati: elenco di spazi dei nomi di identità personalizzati per i quali mancano descrizioni. Utilizza l’icona del collegamento accanto a ogni spazio dei nomi per visualizzarlo o modificarlo.
Per ulteriori informazioni, consulta la documentazione su creazione di spazi dei nomi personalizzati.
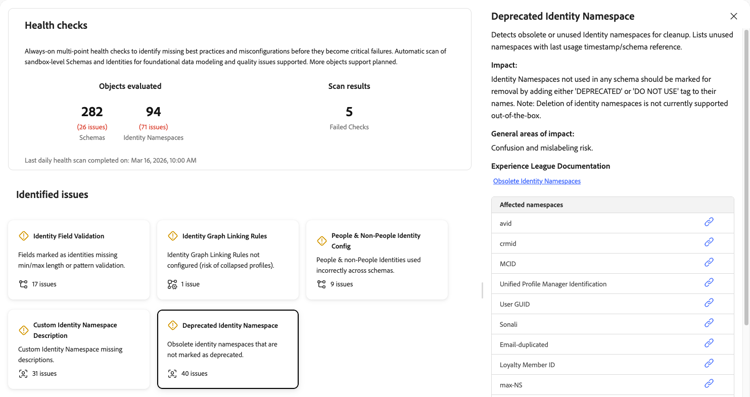
Spazio dei nomi identità non in uso namespace-not-in-use
Rileva gli spazi dei nomi di identità obsoleti o non utilizzati che devono essere contrassegnati per la pulizia. Questo controllo era precedentemente documentato come “Spazio dei nomi di identità obsoleto”.
Quando selezioni la scheda Spazio dei nomi identità non in uso, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: rileva spazi dei nomi di identità obsoleti o inutilizzati per la pulizia. Elenca gli spazi dei nomi inutilizzati con la marca temporale dell’ultimo utilizzo o il riferimento dello schema.
- Impatto: gli spazi dei nomi di identità non utilizzati in alcuno schema devono essere contrassegnati per la rimozione aggiungendo un tag “DEPRECATED” o “DO NOT USE” ai loro nomi. L’eliminazione degli spazi dei nomi delle identità non è attualmente supportata.
- Aree di impatto generali: rischio di confusione e di etichettatura errata.
- Documentazione di Experience League: un collegamento agli spazi dei nomi delle identità obsolete per ulteriore documentazione.
- Spazi dei nomi interessati: elenco di spazi dei nomi di identità obsoleti o inutilizzati. Utilizza l’icona del collegamento accanto a ogni spazio dei nomi per visualizzarlo o gestirlo.
Per ulteriori informazioni, consulta l’articolo della Knowledge Base di Experience Cloud sugli spazi dei nomi obsoleti.
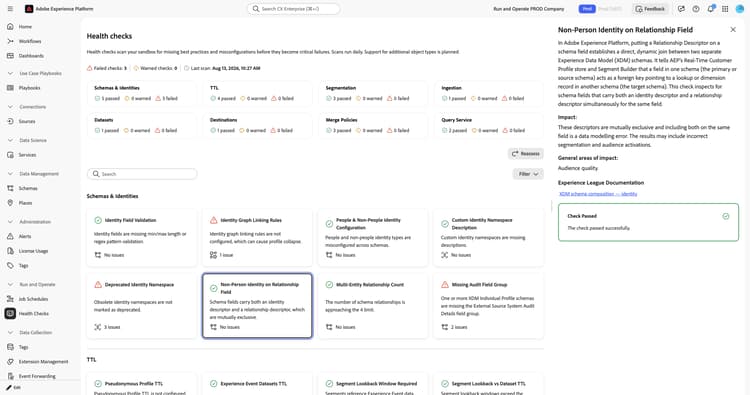
Identità non persona nel campo della relazione non-person-identity-relationship-field
Segnala i campi dello schema che contengono sia un descrittore di identità che un descrittore di relazione allo stesso tempo.
Quando selezioni la scheda Identità non persona sul campo di relazione, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: spiega che l’inserimento di un descrittore di relazione in un campo dello schema determina un join dinamico diretto tra due schemi separati. Indica all’archivio Real-Time Customer Profile e a Audience Builder che un campo nello schema primario o di origine funge da chiave esterna che punta a un record di ricerca o di dimensione nello schema di destinazione. Questo controllo controlla i campi dello schema che contengono sia un descrittore di identità che un descrittore di relazione per lo stesso campo.
- Impatto: questi descrittori si escludono a vicenda e l’inclusione di entrambi sullo stesso campo è un errore di modellazione dei dati. I risultati possono includere segmentazione non corretta e attivazioni del pubblico.
- Aree di impatto generali: qualità del pubblico.
- Documentazione di Experience League: collegamento alla composizione dello schema XDM per l’identità.
- Schemi interessati: elenco di schemi con campi con descrittori in conflitto, se applicabile. Quando non vengono rilevati problemi, nel pannello viene visualizzata una conferma di Controllo superato.
Per ulteriori informazioni, vedere la documentazione sulla composizione dello schema.
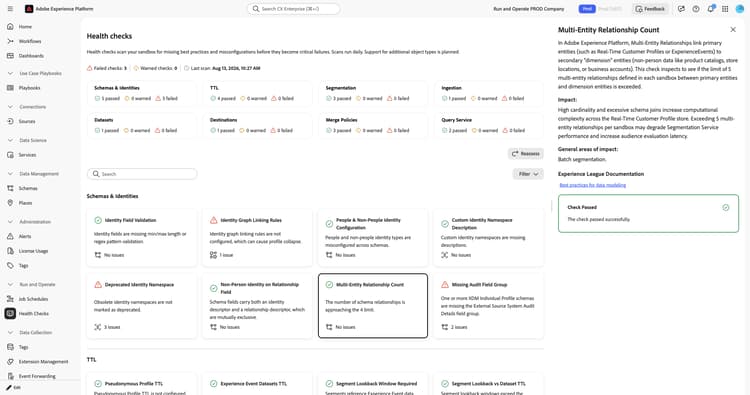
Conteggio delle relazioni tra più entità multi-entity-relationship-count
Monitora il numero di relazioni tra più entità definite in una sandbox quando si avvicinano al limite della piattaforma.
Quando selezioni la scheda Conteggio relazioni tra più entità, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: spiega che le relazioni tra più entità collegano entità primarie, ad esempio Real-Time Customer Profiles o ExperienceEvents, a entità di dimensione secondarie, ad esempio cataloghi di prodotti, posizioni di store o account aziendali. Questo controllo controlla se viene superato il limite di 5 relazioni tra più entità definite nella sandbox.
- Impatto: la cardinalità elevata e l’eccesso di join dello schema aumentano la complessità di calcolo nell’archivio Real-Time Customer Profile. Il superamento del limite può compromettere le prestazioni del servizio di segmentazione e aumentare la latenza di valutazione del pubblico.
- Aree di impatto generali: segmentazione batch.
- Documentazione di Experience League: collegamento alle best practice per la modellazione dei dati.
Per ulteriori informazioni, consulta le best practice per la modellazione dei dati e l’esercitazione sulla segmentazione di più entità.
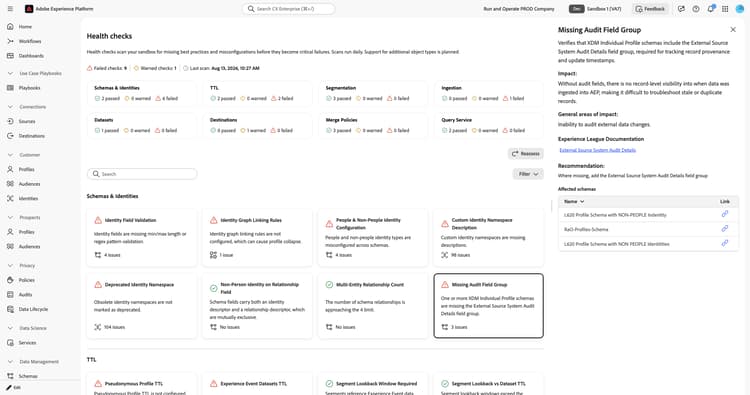
Gruppo di campi di audit mancante missing-audit-field-group
Verifica che gli schemi dei profili individuali XDM includano il gruppo di campi Dettagli controllo del sistema Source esterno.
Quando selezioni la scheda Gruppo di campi di controllo mancante, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: verifica che gli schemi dei singoli profili XDM includano il gruppo di campi Dettagli controllo del sistema Source esterno, necessario per tenere traccia della provenienza dei record e aggiornare i timestamp.
- Impatto: senza campi di controllo, non è disponibile alcuna visibilità a livello di record nel momento in cui i dati sono stati acquisiti in Experience Platform, il che rende difficile la risoluzione dei problemi relativi a record obsoleti o duplicati.
- Aree di impatto generali: impossibile controllare le modifiche ai dati esterni.
- Documentazione di Experience League: collegamento al gruppo di campi Dettagli controllo del sistema Source esterno.
- Consiglio: se mancante, aggiungere il gruppo di campi Dettagli controllo sistema Source esterno.
- Schemi interessati: elenco di schemi a cui manca il gruppo di campi. Utilizza l’icona del collegamento accanto a ogni schema per aprirlo.
Per ulteriori informazioni, vedere la Documentazione del gruppo di campi Dettagli controllo del sistema di Source esterno.
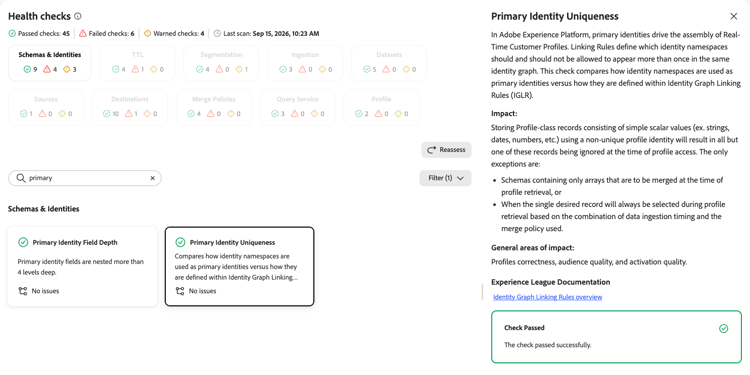
Univocità dell’identità primaria primary-identity-uniqueness
Confronta il modo in cui gli spazi dei nomi di identità vengono utilizzati come identità primarie rispetto a come sono definiti nelle regole di collegamento del grafico delle identità.
Quando selezioni la scheda Univocità identità principale, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: spiega che le identità primarie guidano l’assembly di Real-Time Customer Profiles. Le regole di collegamento definiscono quali spazi dei nomi di identità devono e non devono poter essere visualizzati più di una volta nello stesso grafico delle identità. Questo controllo confronta il modo in cui gli spazi dei nomi di identità vengono utilizzati come identità primarie con il modo in cui vengono definiti nelle regole di collegamento del grafico delle identità.
- Impatto: l’archiviazione dei record di classe profilo con valori scalari semplici utilizzando un’identità di profilo non univoca fa sì che tutti i record tranne uno vengano ignorati all’accesso al profilo. Si applicano due eccezioni: schemi contenenti solo array uniti e casi in cui il record desiderato viene sempre selezionato in base ai tempi di acquisizione e ai criteri di unione.
- Aree generali di impatto: correttezza del profilo, qualità del pubblico e qualità di attivazione.
- Documentazione di Experience League: collegamento alla panoramica delle regole di collegamento del grafico delle identità.
Per ulteriori informazioni, vedere la panoramica delle regole di collegamento del grafico delle identità.
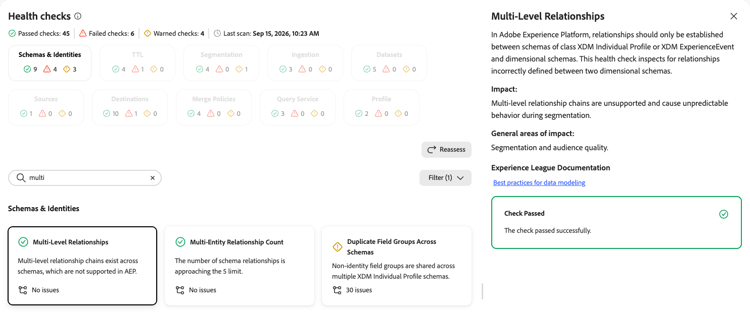
Relazioni multilivello multi-level-relationships
Rileva relazioni definite in modo errato tra schemi bidimensionali.
Quando selezioni la scheda Relazioni a più livelli, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: spiega che le relazioni devono essere stabilite solo tra schemi di XDM Individual Profile o XDM ExperienceEvent di classe e schemi dimensionali. Questo controllo verifica la presenza di relazioni definite in modo errato tra schemi bidimensionali.
- Impatto: le catene di relazioni a più livelli non sono supportate e causano un comportamento imprevedibile durante la segmentazione.
- Aree di impatto generali: segmentazione e qualità del pubblico.
- Documentazione di Experience League: collegamento alle best practice per la modellazione dei dati.
Per ulteriori informazioni, consulta le best practice per la modellazione dei dati.
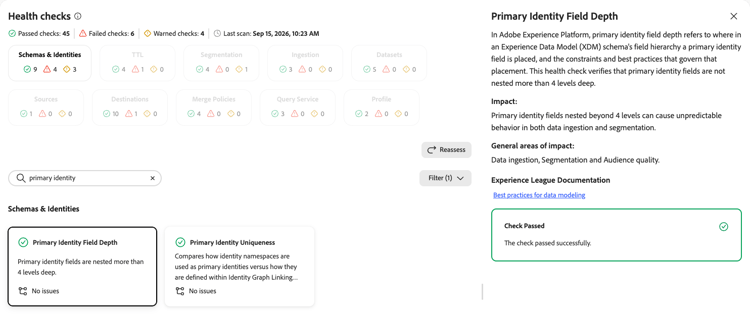
Profondità campo identità primaria primary-identity-field-depth
Verifica che i campi di identità primaria non siano nidificati troppo in profondità nella gerarchia dei campi dello schema.
Quando selezioni la scheda Profondità campo identità primaria, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: spiega che la profondità del campo di identità principale si riferisce alla posizione nella gerarchia dei campi di uno schema XDM in cui viene inserito un campo di identità principale, nonché ai vincoli e alle best practice che regolano tale posizione. Questo controllo verifica che i campi di identità primaria non siano nidificati a più di quattro livelli di profondità.
- Impatto: i campi di identità primari nidificati oltre i quattro livelli possono causare un comportamento imprevedibile sia nell’acquisizione dei dati che nella segmentazione.
- Aree di impatto generali: acquisizione dei dati, segmentazione e qualità del pubblico.
- Documentazione di Experience League: collegamento alle best practice per la modellazione dei dati.
Per ulteriori informazioni, consulta le best practice per la modellazione dei dati.
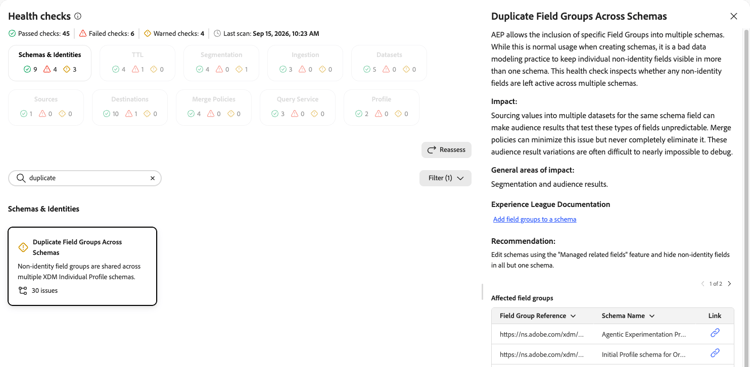
Gruppi di campi duplicati tra schemi duplicate-field-groups-across-schemas
Rileva i gruppi di campi non di identità che rimangono attivi in più schemi.
Quando selezioni la scheda Duplica gruppi di campi tra schemi, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: spiega che Experience Platform consente di includere gruppi di campi specifici in più schemi. Anche se si tratta di un utilizzo normale durante la creazione di schemi, non è buona norma ricorrere alla modellazione dei dati per mantenere visibili i singoli campi non di identità in più di uno schema. Questo controllo controlla se eventuali campi non di identità sono rimasti attivi in più schemi.
- Impatto: l’origine dei valori in più set di dati per lo stesso campo schema può rendere imprevedibili i risultati del pubblico che sottopongono a test questi campi. I criteri di unione possono ridurre questo problema ma non eliminarlo mai completamente e spesso è difficile eseguire il debug delle varianti risultanti.
- Aree di impatto generali: segmentazione e risultati del pubblico.
- Documentazione di Experience League: un collegamento per aggiungere gruppi di campi a uno schema.
- Consiglio: modifica gli schemi utilizzando la funzionalità dei campi correlati gestiti e nascondi i campi non di identità in tutti gli schemi tranne uno.
- Gruppi di campi interessati: elenco di gruppi di campi condivisi tra schemi, con il riferimento al gruppo di campi e il nome dello schema. Utilizza l’icona del collegamento per aprire lo schema.
Per ulteriori informazioni, vedere Aggiungere gruppi di campi a uno schema.
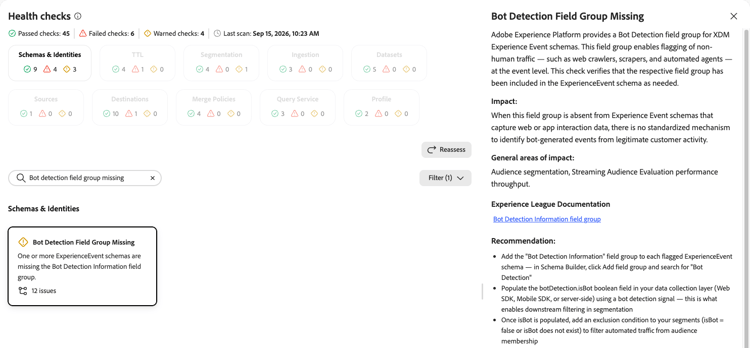
Gruppo di campi di rilevamento bot mancante bot-detection-field-group-missing
Verifica che gli schemi ExperienceEvent includano il gruppo di campi Informazioni sul rilevamento bot.
botDetection.isBot utilizzando un segnale di rilevamento bot, quindi escludi i bot dai segmenti.Quando selezioni la scheda Gruppo di campi di rilevamento bot mancante, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: spiega che Experience Platform fornisce un gruppo di campi Rilevamento bot per gli schemi ExperienceEvent XDM. Questo gruppo di campi consente di contrassegnare a livello di evento il traffico non umano, ad esempio crawler web, raschiatori e agenti automatizzati. Questa verifica verifica se il gruppo di campi è stato incluso nello schema ExperienceEvent in base alle esigenze.
- Impatto: quando questo gruppo di campi è assente dagli schemi ExperienceEvent che acquisiscono dati di interazione web o app, non esiste un meccanismo standardizzato per identificare gli eventi generati da bot dall’attività legittima del cliente.
- Aree generali di impatto: velocità effettiva di segmentazione del pubblico e valutazione del pubblico in streaming.
- Documentazione di Experience League: collegamento al gruppo di campi Informazioni sul rilevamento bot.
- Consiglio: aggiungere il gruppo di campi Informazioni sul rilevamento bot a ogni schema ExperienceEvent contrassegnato. Popola il campo
botDetection.isBotutilizzando un segnale di rilevamento bot, quindi escludi i bot dai segmenti.
Per ulteriori informazioni, vedere la documentazione del gruppo di campi Informazioni rilevamento bot.
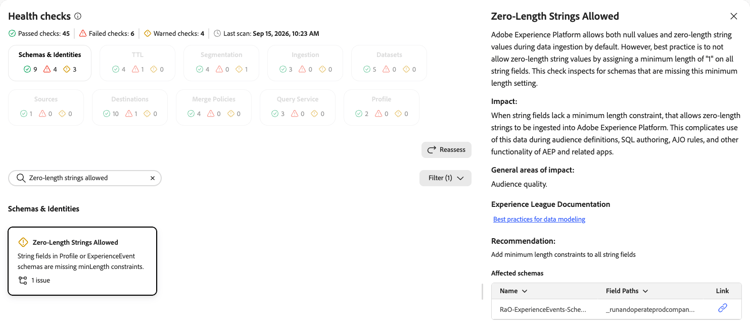
Stringhe di lunghezza zero consentite zero-length-strings-allowed
Verifica che i campi stringa richiedano una lunghezza minima di un carattere.
Quando selezioni la scheda Stringhe a lunghezza zero consentite, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: spiega che Experience Platform consente sia valori Null che valori stringa di lunghezza zero durante l’acquisizione dei dati per impostazione predefinita. Si consiglia di non consentire valori stringa di lunghezza zero assegnando una lunghezza minima di uno su tutti i campi stringa. Questo controllo controlla gli schemi per i quali manca questa impostazione della lunghezza minima.
- Impatto: quando i campi stringa non dispongono di un vincolo di lunghezza minima, è possibile acquisire stringhe di lunghezza zero, il che complica l’utilizzo di questi dati durante le definizioni di pubblico, l’authoring SQL, le regole Adobe Journey Optimizer e altre funzionalità.
- Aree di impatto generali: qualità del pubblico.
- Documentazione di Experience League: collegamento alle best practice per la modellazione dei dati.
- Consiglio: aggiungi vincoli di lunghezza minima a tutti i campi stringa.
- Schemi interessati: elenco degli schemi e dei percorsi dei campi interessati. Utilizza l’icona del collegamento per aprire lo schema.
Per ulteriori informazioni, consulta le best practice per la modellazione dei dati.
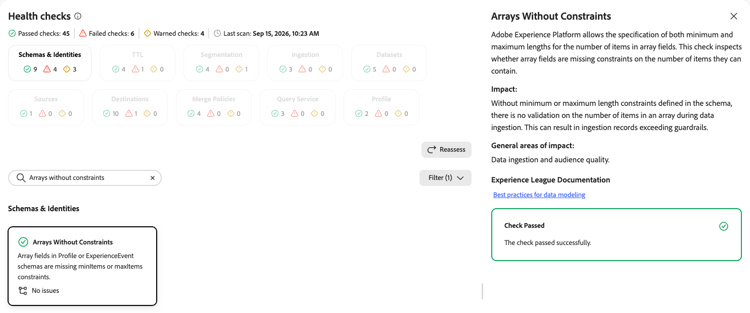
Array senza vincoli arrays-without-constraints
Verifica che i campi array definiscano i vincoli di elemento minimo e massimo.
Quando selezioni la scheda Array senza vincoli, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: spiega che Experience Platform consente di specificare sia la lunghezza minima che la lunghezza massima per il numero di elementi nei campi matrice. Questo controllo controlla se nei campi array mancano vincoli sul numero di elementi che possono contenere.
- Impatto: senza i vincoli di lunghezza minima o massima definiti nello schema, non esiste alcuna convalida sul numero di elementi in un array durante l’acquisizione dei dati, il che può causare record di acquisizione che superano i guardrail.
- Aree di impatto generali: acquisizione dei dati e qualità del pubblico.
- Documentazione di Experience League: collegamento alle best practice per la modellazione dei dati.
Per ulteriori informazioni, consulta le best practice per la modellazione dei dati.
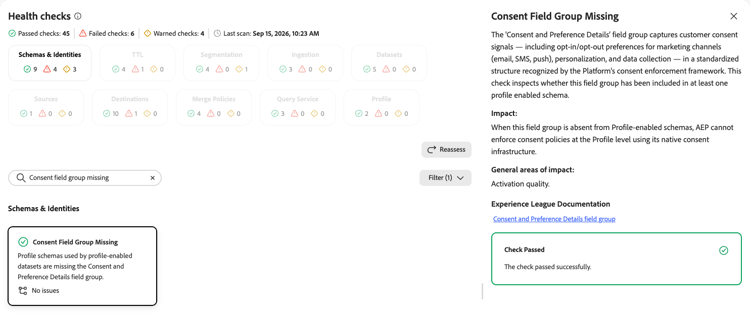
Gruppo di campi di consenso mancante consent-field-group-missing
Verifica che gli schemi abilitati per il profilo includano il gruppo di campi Dettagli consenso e preferenze.
Quando selezioni la scheda Gruppo di campi di consenso mancante, a destra viene visualizzato un pannello dei dettagli. Il pannello mostra:
- Descrizione: spiega che il gruppo di campi Consensi e preferenze acquisisce i segnali di consenso del cliente, come le preferenze di consenso e rinuncia per i canali di marketing, la personalizzazione e la raccolta dati, in una struttura standardizzata. Questa verifica verifica se il gruppo di campi è incluso in almeno uno schema abilitato per il profilo.
- Impatto: quando questo gruppo di campi è assente dagli schemi abilitati per il profilo, Experience Platform non può applicare i criteri di consenso a livello di profilo utilizzando la relativa infrastruttura di consenso nativa.
- Aree di impatto generali: qualità attivazione.
- Documentazione di Experience League: collegamento al gruppo di campi Consensi e preferenze.
Per ulteriori informazioni, consulta la documentazione del gruppo di campi Consensi e preferenze.
Passaggi successivi next-steps
- Torna alla panoramica dei controlli di integrità per esplorare altre categorie di controlli.
- Scopri le best practice per gli schemi per la progettazione di modelli di dati affidabili.
- Comprendere le regole di collegamento del grafico delle identità per evitare la compressione del profilo.
- Consulta la documentazione sullo spazio dei nomi delle identità per le best practice per la gestione dello spazio dei nomi.