Aktivieren der Zuordnung
Sie können das Zusammenfügen mit einem oder mehreren Ereignisdatensätzen aktivieren, die Sie im Rahmen Ihrer Verbindung konfiguriert haben. Das lizenzierte Customer Journey Analytics-Paket bestimmt die Anzahl der Ereignisdatensätze, die Sie für das Zusammenfügen aktivieren können.
Sie aktivieren das Zusammenfügen als Teil der Datensatzeinstellungen für einen Ereignis-Datensatz, wenn Sie Verbindung erstellen oder Verbindung bearbeiten.
Voraussetzungen
Sie müssen die Voraussetzungen für die von Ihnen angegebene Stitching-Methode überprüfen und erfüllen: feldbasiertes Stitching oder grafisches Stitching.
Vorflugkontrollen
Wenn Sie die Voraussetzungen erfüllen, führen Sie einige Preflight-Prüfungen für die Daten im Ereignis-Datensatz durch, bevor Sie die Identitätszuordnung aktivieren:
-
Wenn Sie Experience-Datenmodell (XDM)-Schema Felder für persistente ID oder Personen-ID verwenden, stellen Sie sicher, dass Identitäten im Schema für den Ereignis-Datensatz ordnungsgemäß markiert sind. Siehe Übersicht über Identity-Namespaces.
-
Identitätsabdeckung sowohl für persistente ID als auch für Personen-ID überprüfen:
-
Persistent ID
Abfragen von Daten von sieben Tagen, wenn Ihr persistentes ID-Feld nicht null ist, geteilt durch eine Abfrage von sieben Tagen mit Daten für alle Ereignisse in Ihrem Datensatz. Dieser Prozentsatz sollte über 95 % liegen.
Beispiel einer zu überprüfenden Abfrage:
code language-sql SELECT COUNT(*) AS total_events, COUNT({PERSISTENT_ID_FIELD}) AS events_with_persistentid, ROUND(COUNT({PERSISTENT_ID_FIELD}) / COUNT(*), 2) AS percent_with_persistentid_not_null FROM {DATASET_TABLE_NAME} WHERE TO_TIMESTAMP(timestamp, '{FORMAT_STRING}') >= TIMESTAMP '{START_DATE}' AND TO_TIMESTAMP(timestamp, '{FORMAT_STRING}') < TIMESTAMP '{END_DATE}';Dabei gilt:
{PERSISTENT_ID_FIELD}ist das Feld für die persistente ID. Beispiel:identityMap.ecid[0].{DATASET_TABLE_NAME}ist der Tabellenname für den Ereignis-Datensatz.{FORMAT_STRING}ist die Formatzeichenfolge für das Zeitstempelfeld. Beispiel:MM/DD/YY HH12:MI AM.{START_DATE}ist das Startdatum. Beispiel:2024-01-01 00:00:00.{END_DATE}ist das Enddatum im Standardformat. Beispiel:2024-01-08 00:00:00.
-
Personen-ID
-
Stellen Sie bei diagrammbasiertem Stitching sicher, dass das Identitätsdiagramm Fragmente enthält, die ID-Werte aus dem ausgewählten persistenten ID-Namespace und dem Personen-ID-Namespace verknüpfen. Wechseln Sie zum Experience Platform-Identitätsdiagramm-Viewer und fragen Sie das Diagramm nach einigen beständigen Beispielwerten für IDs ab. Überprüfen Sie, ob diese persistenten ID-Werte mit Personen-ID-Werten im Diagramm verknüpft sind.
-
Fragen Sie für das feldbasierte Stitching 7 Tage Daten ab, bei denen das Feld für Ihre Personen-ID nicht null ist, und teilen Sie dies durch eine Abfrage von 7 Tagen Daten für alle Ereignisse in Ihrem Datensatz. Dieser Prozentsatz sollte idealerweise über 5 % liegen.
Beispiel einer zu überprüfenden Abfrage:
code language-sql SELECT COUNT(*) AS total_events, COUNT({PERSON_ID_FIELD}) AS events_with_personid, ROUND(COUNT({PERSON_ID_FIELD}) / COUNT(*), 2) AS percent_with_personid_not_null FROM {DATASET_TABLE_NAME} WHERE TO_TIMESTAMP(timestamp, '{FORMAT_STRING}') >= TIMESTAMP '{START_DATE}' AND TO_TIMESTAMP(timestamp, '{FORMAT_STRING}') < TIMESTAMP '{END_DATE}';Dabei gilt:
{PERSON_ID_FIELD}ist das Feld für die Personen-ID. Beispiel:identityMap.crmId[0].{DATASET_TABLE_NAME}ist der Tabellenname für den Ereignis-Datensatz.{FORMAT_STRING}ist die Formatzeichenfolge für das Zeitstempelfeld. Beispiel:MM/DD/YY HH12:MI AM.{START_DATE}ist das Startdatum. Beispiel:2024-01-01 00:00:00.{END_DATE}ist das Enddatum im Standardformat. Beispiel:2024-01-08 00:00:00.
-
-
Aktivieren der Identitätszuordnung enable-identity-stitching
Sie können die Identitätszuordnung aktivieren wenn Sie Ereignis-Datensatz in 🔗 personenbasierten Verbindung hinzufügen oder bearbeiten. Identitätszuordnung ist für kontobasierte Verbindungen nicht verfügbar.
Datensatzeinstellungen
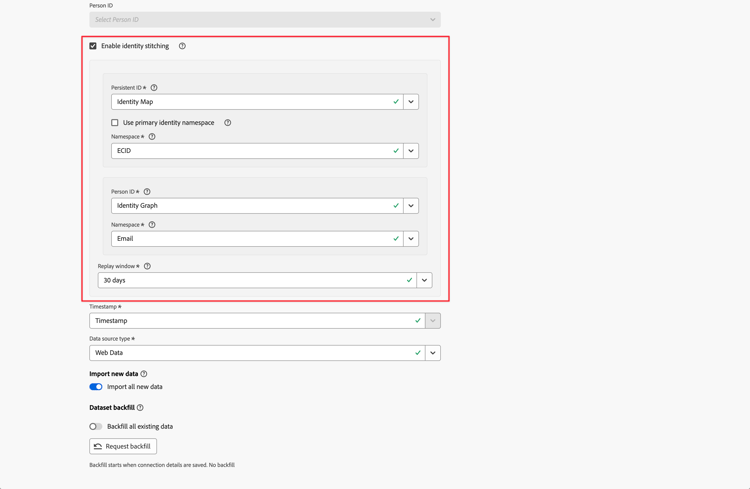
Um das Zusammenfügen zu aktivieren, verwenden Sie den Abschnitt Datensatzeinstellungen des Dialogfelds Datensätze hinzufügen oder Datensatz bearbeiten.
-
Wählen Sie Identitätszusammenfügung aktivieren aus.
Wenn Sie das Zusammenfügen für einen gespeicherten Ereignisdatensatz in der Verbindung aktivieren oder deaktivieren, zeigt Dialogfeld „Personen-ID ändern die Auswirkungen einer Änderung der Personen-ID an. Wählen Sie Weiter aus, um fortzufahren.
Das „Identitätszuordnung aktivieren fasst die Auswirkungen des Zuordnens von Identitäten zusammen. Wählen Sie Weiter aus, um fortzufahren.
-
Wählen Sie eine persistente ID aus Dropdown-Menü Persistente ID“ aus.
Wenn Sie Identitätszuordnung) für persistente ID auswählen, wählen Sie einen Namespace aus. Sie haben nun zwei Möglichkeiten:
- Wählen Sie Primären Identity-Namespace verwenden aus, um den primären Identity-Namespace zu verwenden.
- Wählen Sie einen Namespace aus dem Namespace Dropdown-Menü aus.
-
Wählen Sie eine Personen-ID aus Dropdown Menü „Personen-ID“ aus.
Wenn Sie Identitätszuordnung) für Personen-ID auswählen, wählen Sie einen Namespace aus. Sie haben nun zwei Möglichkeiten:
- Wählen Sie Primären Identity-Namespace verwenden aus, um den primären Identity-Namespace zu verwenden.
- Wählen Sie einen Namespace aus dem Namespace Dropdown-Menü aus.
Wenn Sie Identitätsdiagramm für die Personen-ID (zur Verwendung des Diagrammbasierten Stitching) auswählen, müssen Sie einen Namespace auswählen.
note NOTE Stellen Sie sicher, dass Sie berechtigt sind, das Identitätsdiagramm zu verwenden. Zuvor wird das Dialogfeld Änderung am Identitätsdiagramm angezeigt, um sicherzustellen, dass Sie die Einrichtung des Identitätsdiagramms für den Datensatz abgeschlossen haben. Diese Einrichtung ist Teil der Diagrammbasierten Voraussetzungen bevor Sie das Identitätsdiagramm zum Zusammenfügen verwenden können. Wählen Sie Weiter aus, um fortzufahren.
- Wählen Sie einen Namespace aus dem Namespace Dropdown-Menü aus.
-
Wählen Sie im Dropdown-Menü Wiederholungsfenster ein Wiederholungsfenster aus. Die verfügbaren Optionen hängen vom Customer Journey Analytics-Paket ab, zu dem Sie berechtigt sind.
-
Wählen Sie Weiter aus, um eine Vorschau des Ereignis-Datensatzes anzuzeigen, der zugeordnet werden soll.
Datensatzvorschau
Zusätzlich zur standardmäßigen Benutzeroberfläche Datensatzvorschau stehen beim Hinzufügen oder Bearbeiten von Datensätzen in einer personenbasierten Verbindung zwei zusätzliche Informationsbereiche zur Verfügung.
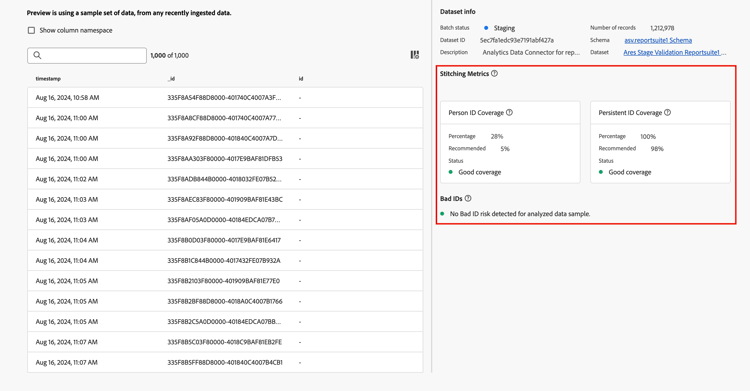
Zuordnungsmetriken
Zuordnungsmetriken werden anhand eines Beispielsatzes von Daten mit Ereignis-Zeitstempeln der letzten 7 Tage berechnet. Dieser Beispieldatensatz unterscheidet sich in der Regel von den Beispieldaten, die in der Tabelle Vorschau verwendet werden. Zuordnungsmetriken bieten Details für:
-
Personen-ID-Abdeckung: Die Abdeckung der ausgewählten Personen-ID, die während des Zuordnungsprozesses (Live und Wiederholung) zur Identifizierung verwendet wird.
- Für die besten feldbasierten Zuordnungsergebnisse sollte bei mindestens einem Ereignis für jede persistente ID (Geräteinformationen) eine Personen-ID (Benutzerinformationen) gesendet werden.
- Für die besten diagrammbasierten Zuordnungsergebnisse sollte im Identitätsdiagramm für jede persistente ID eine Beziehung (persistente ID, Personen-ID) vorhanden sein.
Die Personen-ID-Abdeckung wird als Prozentsatz angezeigt und mit den Empfehlungen bei einer stabilen Entwicklung oder in einer Produktionseinrichtung verglichen. Je höher dieser Abdeckungswert ist, desto bessere Stitching-Ergebnisse werden mit der ausgewählten Personen-ID erzielt.
-
Persistente ID-Abdeckung: Dieser Wert wird während des Zuordnungsprozesses (Live und Wiederholung) zur Identifizierung verwendet, falls ein Personen-ID-Wert nicht erkannt werden kann. Ereignisse ohne dauerhafte ID und ohne Personen-ID werden aus den Daten gelöscht. Um optimale Ergebnisse bei der Zuordnung zu erzielen, sollte für alle Ereignisse eine dauerhafte ID vorhanden sein.
Die persistente ID-Abdeckung wird als Prozentsatz angezeigt und mit dem verglichen, was bei einer stabilen Entwicklung oder in einer Produktionseinrichtung als Minimum empfohlen wird.
Ungültige IDs
In Customer Journey Analytics ist eine ungültige ID ein Bezeichner:
- mit einem bestimmten ID-Wert, der entweder aus einem persistenten ID- oder einem Personen-ID-Feld in zusammenfügbaren Datensätzen stammt, und
- wird monatlich für mehr als eine Million (1.000.000) Ereignisse in den Verbindungsdaten angezeigt.
Wenn ein ID-Wert als ungültige ID markiert wird, werden alle zukünftigen Ereignisse, die diesen ID-Wert enthalten, aus den Verbindungsdaten verworfen und nicht im Bericht angezeigt.
Beispiele für Anwendungsfälle mit ungültigen IDs:
- Das Feld Personen-ID enthält benutzerdefinierte Werte oder Platzhalterwerte (z. B.
undefined). Solche Werte können sich auch auf Zuordnung und Qualität der Berichtsdaten auswirken. - Wenn sich in einer feldbasierten Stitching-Konfiguration mehrere Personen ein Gerät teilen und die Gesamtzahl der Transitionen zwischen Benutzerinnen und Benutzern 50.000 überschreitet. In diesem Szenario stoppt der Zuordnungsprozess die Verwendung der Personen-ID-Informationen für dieses Gerät und verwendet stattdessen nur persistente ID-Informationen. Daher werden alle Datensatzereignisse von diesem Gerät an Verbindungsdaten mit der persistenten ID-Identität gesendet, was wahrscheinlich eine Situation mit ungültigen IDs verursacht.
Speichern
Nachdem Sie eine Verbindung gespeichert haben, wird der Prozess zum Aktivieren der Zuordnung für die konfigurierten Datensätze ausgelöst. Sobald der Zusammenfügungs-Service eingerichtet ist, verarbeitet der Service die Live-Streaming-Daten und die angeforderte Aufstockung aus den Ereignisdatensätzen in Experience Platform. Anschließend werden Daten in die Customer Journey Analytics-Verbindung aufgenommen.
Jeder Teil des Prozesses führt zu bestimmten Verzögerungen. Die folgenden Verarbeitungszeiten sind Leitplanken, keine vertraglichen Service Level Agreements (SLAs).
Für ein gültiges anfängliches Verbindungssetup, das gespeichert wird und einen Datensatz mit aktiviertem Stitching enthält:
-
Live-Daten werden zunächst nach einigen Stunden in Customer Journey Analytics angezeigt (weniger als 14 Stunden). Neue Live-Daten sind innerhalb weniger Stunden verfügbar. Die Live-Daten beginnen mit Ereignis-Zeitstempelwerten, die mit dem tatsächlichen Zeitpunkt übereinstimmen, zu dem die Zuordnungsaktivierung abgeschlossen wurde.
Um sicherzustellen, dass Live-Daten eingehen, aktivieren Sie die Option Alle neuen Daten importieren für den Datensatz.
-
Aufstockte Daten (falls ursprünglich angefordert) werden etwa zur gleichen Zeit wie Live-Daten in Customer Journey Analytics angezeigt, deren vollständige Verarbeitung jedoch je nach Volumen Tage dauern kann. Die aufgestockten Daten beginnen mit den ältesten Zeitstempelwerten des Ereignisses.
note caution CAUTION Für Datensätze, die in Verbindungsschnittstelle für das aktiviert sind, kann der Aufstockungsstatus aufgrund einer bekannten Einschränkung nicht gemeldet werden. Verwenden Sie alternative Möglichkeiten, um zu überprüfen, ob Daten aus dem zusammengefügten Datensatz aufgestockt werden. Verwenden Sie beispielsweise die Benutzeroberfläche des Experience Platform-, um die Ereignisanzahl für den relevanten Zeitraum aus dem Datensatz zu extrahieren. Vergleichen Sie diese Ereignisse mit dem Metrikwert Ereignisse in Customer Journey Analytics-Berichten für denselben Zeitrahmen. Wenn diese Zahlen übereinstimmen, wird die Aufstockung abgeschlossen.
Einschränkungen
Zusätzlich zu den feldbasierten Stitching-Einschränkungen und graphbasierten Stitching-Einschränkungen gelten die folgenden Einschränkungen, wenn Sie das Stitching in der Verbindungsschnittstelle aktivieren:
- Sie können einen Ereignis-Datensatz nur einmal als Teil einer einzelnen Verbindung zuordnen. Sie können denselben Ereignisdatensatz nicht mehrmals definieren und für jede Instanz eine separate Stitching-Konfiguration verwenden. Wenn Sie verschiedene Zuordnungskonfigurationen auf denselben Datensatz anwenden möchten, verwenden Sie für jede Konfiguration eine separate Verbindung.
Migration
Das in der Verbindungsschnittstelle aktivierte Stitching kann ohne Probleme mit dem anforderungsbasierten Stitching gleichzeitig verwendet werden.
Sie haben beispielsweise Web-basierte zugeordnete Datensätze im Data Lake aufgrund früherer oder aktueller Zuordnungsanfragen. Sie können zugeordnete Daten aus einem Callcenter-Datensatz über die Schnittstelle Verbindungen hinzufügen, um diese Daten mit den Web-basierten Daten zu kombinieren.
Schließlich migriert Adobe Ihre anforderungsbasierten zugeordneten Datensätze zum neuen Stitching im -Erlebnis.