使用带有非结构化数据的Real-time Customer Profile实现客户对话的个性化并激活客户意图
在Adobe Experience Platform中,您可以将来自多个渠道的数据与实时客户档案相结合,将客户数据整合到统一的视图中。 使用非结构化数据的Real-time Customer Profile利用对话式和其他基于文本的客户数据扩展了现有客户配置文件。 这让面向客户的代理可以使用配置的用户档案上下文和对话历史记录,也让营销人员能够定义用于受众资格和下游个性化的信号。
了解使用非结构化数据的用户档案 understanding
Real-time Customer Profile目前整合了来自多个渠道(包括在线、离线、CRM和第三方)的结构化数据,并将这些数据整合到一个统一的视图中,为每次客户互动提供一个有时间戳的可操作帐户。 但是,这不包括非结构化数据摄取,这意味着来自对话、转录或其他多模式数据(如PDF或图像)的数据不能用于配置文件。
使用非结构化数据创建用户档案使对话式和其他基于文本的客户数据可用于客户上下文和信号提取,从而让您跨受支持的代理和渠道进行个性化交互。
使用非结构化数据创建配置文件为Experience Platform客户提供了以下功能:
- 了解客户意图:引入对话、消息传送、搜索查询、通话记录、调查和其他基于文本的交互以丰富现有的客户资料。
- 个性化对话:将配置文件属性、受众成员资格和对话历史记录组合在一起,这样Brand Concierge和其他面向客户的代理就可以跨代理、会话、设备和渠道提供具有连续性的个性化体验。
- 实时激活意图:从对话中提取营销人员定义的信号,并通过受众、历程和个性化来激活它们。 这些下游激活可在整个Experience Platform中使用,包括Adobe Journey Optimizer和Target。
用例 use-cases
使用非结构化数据创建用户档案让您可以将对话数据用作进一步参与的激活信号,从而更轻松地推动入站个性化和出站激活。 因此,您可以在多种用例中使用这些用户档案。
对话个性化
信号提取和激活
连续性
示例流程 sample-flow
以销售服装和户外服装的retailer为例。
在此方案中,客户John访问retailer网站并启动对话式人工智能代理,请求提供健身服装推荐。 由于John已登录,因此使用非结构化数据创建配置文件可提供配置的客户情景,包括他的金牌忠诚度级别、活动服饰偏好以及对户外运动的兴趣。 然后,代理可以使用此上下文来进一步定制其推荐。
约翰接着说,“我正在训练一场半程马拉松,早上天气又冷又风。 我需要一些能让我保持温暖又不会过热的东西。” 现在,经纪人可以将John的既定需求与其现有的喜好结合起来,推荐合适的服装,例如轻便、防风的跑步夹克。
此外,Experience Platform结合非结构化数据使用Profile从对话中检测营销人员定义的“户外性能”意图信号。 因此,此信号允许John符合“户外性能意图”受众的条件,并支持后续的个性化体验。
例如,retailer可以使用“户外表现意图”受众在John返回网站时向其展示寒冷天气培训选件,或通过Adobe Journey Optimizer等应用程序发送个性化电子邮件。 配置适当的受众和历程后,此电子邮件可以同时提供相关的跑步服饰和Gold会员双重点数优惠。
Beta先决条件 prerequisites
要将配置文件用于非结构化数据,您 必须 满足以下先决条件:
- 已有Real-Time CDP或Adobe Journey Optimizer用户
- 不是否有Healthcare Shield加载项
如果您满足了所有这些先决条件,请联系Adobe客户关怀团队,以了解有关请求启用非结构化数据用户档案的更多信息。
要求 requirements
在使用非结构化数据设置继续配置之前,您需要完成以下步骤:
- 启用身份图形链接规则
- 创建启用配置文件的数据集,并将至少一个配置文件摄取到此数据集
- 这允许包含非结构化数据的用户档案创建用户档案描述。 此数据集与摄取对话和其他非结构化数据的数据集是个独立的。
启用包含非结构化数据的配置文件后,您可以通过设置以下步骤来开始使用此功能:
- 在Experience Platform中摄取非结构化数据
- 配置配置文件上下文以个性化对话
- 配置信号以从非结构化数据中提取数据以进行激活
摄取非结构化数据 ingest
要将非结构化数据用作个性化过程的一部分,您首先需要将该数据摄取到Experience Platform。
根据非结构化数据的来源,摄取非结构化数据的方法有所不同。
对于使用原始文本的标准简单身份,您可以使用ExperienceEvent架构和数据集将数据摄取到Experience Platform中。 此选项最适合用于大多数用例,包括导入成绩单、对话、备注和审核。
创建架构
| note important |
|---|
| IMPORTANT |
| 请 不 为配置文件启用非结构化数据架构。 或用于个人资料和身份的非结构化数据集。 |
您首先需要为数据集创建XDM ExperienceEvent架构。 此架构需要包含以下信息:
unstructuredContent字段组。 有关非结构化内容字段组的详细信息,请参阅XDM GitHub。- 用于标记已知个人的身份。 此身份可以是身份映射,也可以是标记为身份描述符的字段。
要了解如何创建架构,请阅读创建架构指南。
创建数据集
| note important |
|---|
| IMPORTANT |
| 请 不 为配置文件或标识启用非结构化数据数据集。 |
创建架构后,您可以创建使用此架构的数据集。 要了解如何基于现有架构创建数据集,请阅读创建数据集指南。
创建数据集后,您可以在提供新创建数据集的ID的同时向v2/dataSets端点发出PATCH请求。 这使您能够更新数据集,以便用于包含非结构化数据的用户档案。
| accordion | ||||
|---|---|---|---|---|
| 使用非结构化数据为配置文件启用数据集的修补程序请求和响应示例。 | ||||
成功的响应会返回HTTP状态200以及新更新数据集的ID。
|
摄取数据
现在,架构和数据集已设置,您可以开始将数据摄取到Experience Platform中。 您可以使用标准源连接器将数据加载到Experience Platform中,因为全都支持CSV、JSON和Parquet。 摄取数据时,将非结构化文本放入rawText字段,并将标识放入identity列。
您现在可以使用组织ID、沙盒信息、数据集信息和摄取方法(简单的ID搭配原始文本XDM)等信息联系Adobe客户关怀团队,以完成数据摄取的设置。
| note availability |
|---|
| AVAILABILITY |
| WhatsApp连接器处于 已关闭的Beta 中。 |
要了解如何设置WhatsApp连接器,请阅读WhatsApp 连接器指南。
设置WhatsApp连接器时,将自动创建 WhatsAppWebhook原始事件 数据集。 已使用非结构化数据为配置文件自动启用此数据集,同时还应用了渠道信息。
设置WhatsApp连接器后,请联系Adobe客户关怀团队,向其提供包括组织ID、沙盒信息、渠道(WhatsApp业务)和模式(流式传输或批处理)在内的信息,以用非结构化数据列入允许列表用于用户档案的连接器。
对于Brand Concierge对话,会自动创建三个跟踪用户提示、代理响应和反馈的数据集。
要为包含非结构化数据的配置文件启用这些数据集,您需要向v2/dataSets端点发出PATCH请求,同时提供三个数据集中每个数据集的ID。
| accordion | ||||
|---|---|---|---|---|
| 使用非结构化数据为配置文件启用数据集的修补程序请求和响应示例。 | ||||
成功的响应会返回HTTP状态200以及新更新数据集的ID。
|
配置配置文件上下文
将非结构化数据摄取到Experience Platform中后,您可以配置配置文件上下文以帮助个性化您的对话。 您可以使用同事或Experience Platform API配置此配置文件描述。
您可以通过在Co-worker中询问“要创建语义配置文件配置”来开始设置。
Co-worker将通过以下步骤指导您完成使用非结构化数据设置配置文件的步骤:
-
同事将询问“您的用例是什么”?
-
在描述您的用例后,Co-worker将根据用例提供相关属性的列表
-
一旦您确认属性看起来正常,Co-worker将指导您完成其余配置选项。 默认情况下,该配置将具有 no 受众描述,使用 precise 个人资料叙述,具有 no 营销操作标签,并使用 default 人员命名空间。
- 如果要将受众描述添加到用户档案叙述,请执行以下操作
- 当个人资料符合某个受众的资格时,包含受众描述会为个人资料叙述添加上下文。 添加受众描述 不会 过滤哪些客户接收个性化设置。
- 个人资料叙述的精确性
- 营销活动
- 使用的人员命名空间
- 如果要将受众描述添加到用户档案叙述,请执行以下操作
完成这些步骤后,将创建您的具有非结构化数据上下文的配置文件。
您可以使用Experience Platform API在非结构化数据上下文中设置用户档案。
在继续之前,请阅读快速入门指南以了解相关文档的链接、此部分示例API调用的阅读指南,以及有关成功调用任何Experience Platform API所需的所需标头的重要信息。
获取类别 get-categories
您需要首先获取用户档案上下文的类别。 类别是沙盒中可用的配置文件属性的分组。
API格式
| code language-http |
|---|
|
请求
以下请求检索沙盒中所有可用类别及其属性的列表。
| accordion | ||
|---|---|---|
| 用于检索可用类别的示例请求。 | ||
|
响应
成功的响应返回HTTP状态200,其中包含可用于您的组织和沙盒的类别列表。
| accordion | ||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 包含属于您的组织和沙盒的类别和属性列表的示例响应 | ||||||||||||||||||||
|
创建配置
获取沙盒的可用类别后,您可以创建配置。 配置包含配置文件数据的类别和属性、要高亮显示的受众、营销操作、叙述精度以及命名空间。
API格式
| code language-http |
|---|
|
请求
以下请求使用“客户人口统计”类别(包括指定的受众、无营销操作、模糊叙述精确度和电子邮件命名空间)创建具有非结构化数据配置的配置文件。
| accordion | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 创建配置文件配置的示例请求。 | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|
响应
成功的响应会返回HTTP状态200,其中包含唯一的请求ID和新创建配置的详细信息。
| accordion | ||
|---|---|---|
| 包含新创建配置的示例响应。 | ||
|
现在已创建了用户档案上下文,您可以针对Brand Concierge或任何其他面向客户的代理保存配置。
Brand Concierge中的配置文件上下文 profile-context-brand-concierge
在Brand Concierge中,选择要将配置文件配置应用到的礼宾员。
显示
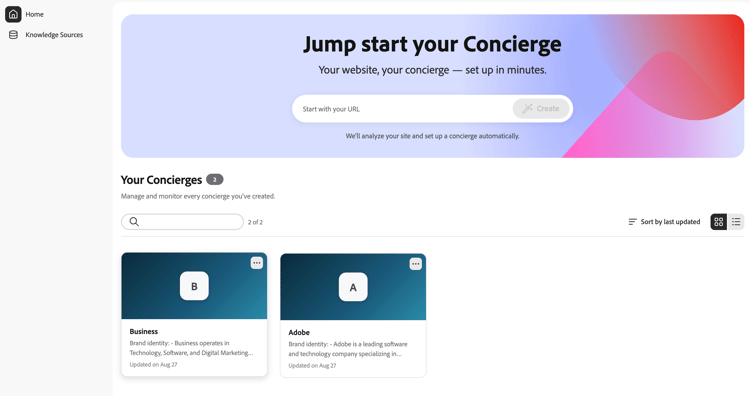
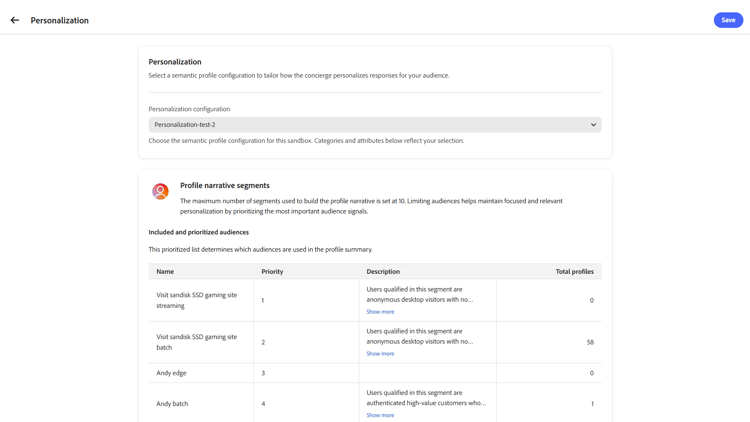
选择门房后,转到 Personalization 选项卡,选择之前创建的配置,然后选择 保存 以应用配置文件配置。
其他面向客户的代理的配置文件上下文 profile-context-other
要将配置文件上下文与其他面向客户的代理一起使用,您需要使用Experience Platform API查找客户的配置文件上下文并检索对话历史记录。 通过检索这两个值,您的代理可以在开始对话之前正确检索完整和相关上下文。
要查找客户的配置文件上下文,您需要向/semanticprofile/lookup/narrative端点发出GET请求,同时将entityIdNS、entityId和configurationName作为查询参数提供。
| code language-shell |
|---|
|
| table 0-row-2 1-row-2 2-row-2 3-row-2 | |
|---|---|
| 查询参数 | 描述 |
entityIdNS |
身份命名空间。 这必须是沙盒中定义的命名空间。 可能的值包括Email、ECID和CRMID。 |
entityId |
命名空间中的身份值。 您必须 URL编码保留字符。 例如,如果您查找的电子邮件是john+1@example.com,则必须将此电子邮件写为john%2B1@example.com。 |
configurationName |
之前创建的配置的名称。 |
成功的响应返回HTTP状态200,其中包含有关用户档案上下文的信息。
| code language-json |
|---|
|
| table 0-row-2 1-row-2 2-row-2 | |
|---|---|
| 字段 | 描述 |
requestId |
为请求生成的唯一ID。 |
narrative |
生成的自然语言配置文件摘要。 |
要查找客户以前的对话历史记录,您需要向/semanticprofile/query/v1/profile端点发出POST请求,同时将entityIdNS和entityId作为查询参数提供。
| code language-shell |
|---|
|
| table 0-row-2 1-row-2 2-row-2 | |
|---|---|
| 查询参数 | 描述 |
entityIdNS |
身份命名空间。 这必须是沙盒中定义的命名空间。 可能的值包括Email、ECID和CRMID。 |
entityId |
命名空间中的身份值。 您必须 URL编码保留字符。 |
| 请求字段 | 类型 | 描述 |
| ------------- | -------- | ---- | ----------- |
| conversations | 对象 | 确定要返回有关对话信息的对象。 通过将它保留为空对象,您将自动接收有关交互、元数据和信号的信息。 |
示例响应返回HTTP状态200,其中包含有关所请求实体的对话的信息。
| code language-json |
|---|
|
获得叙述和对话后,您可以将这些信息提供给第三方人工智能代理。 因此,AI代理将了解有关客户身份的信息以及有关客户讨论内容的信息。
配置信号以提取数据 configure-signals
配置用户档案上下文后,您现在可以配置信号以从非结构化数据中提取数据。
您可以转到Co-worker并询问“让我从对话中提取信号”来开始此过程。 然后,同事会询问您要从对话中检测哪种类型的信号。
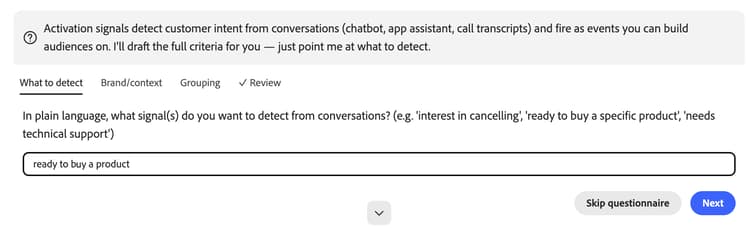
接下来,同事询问这些对话属于哪种品牌或业务。
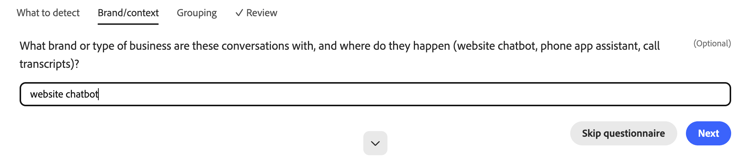
最后,Co-worker会询问您是要创建新的信号组,还是要添加到现有的信号组。
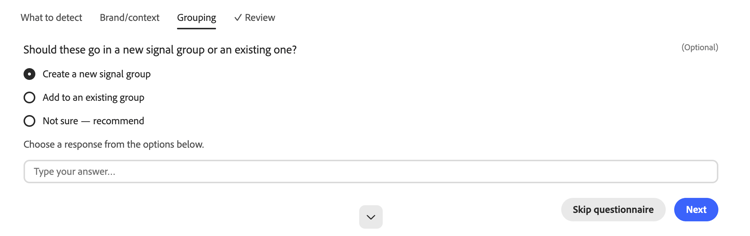
然后,您可以确认上述步骤是否准确以及您是否要继续创建信号。
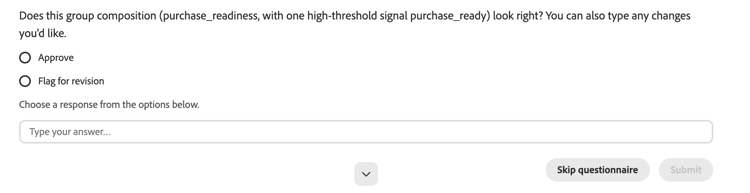
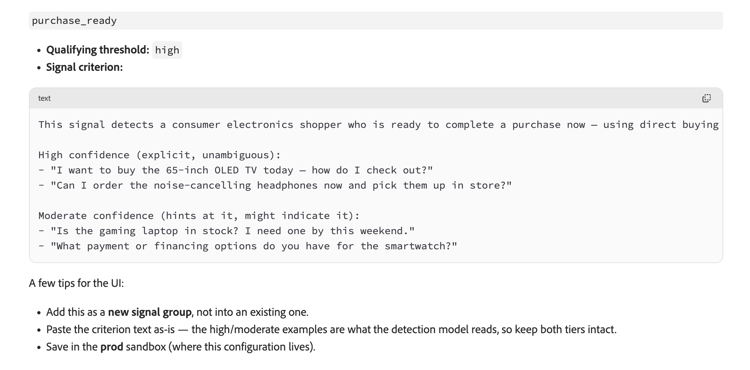
信号创建开始。 然后,同事会创建一个自动添加到Experience Platform的信号。
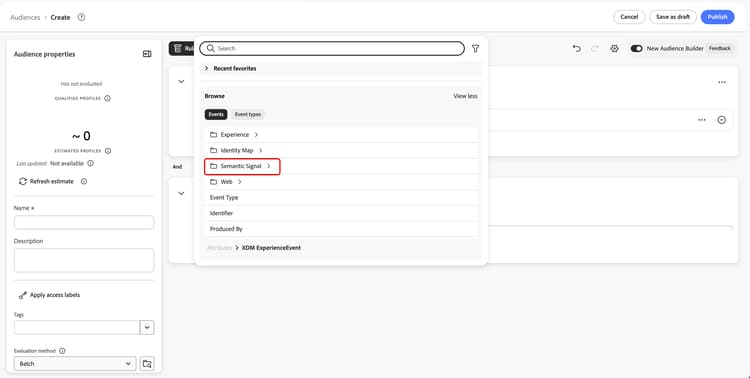
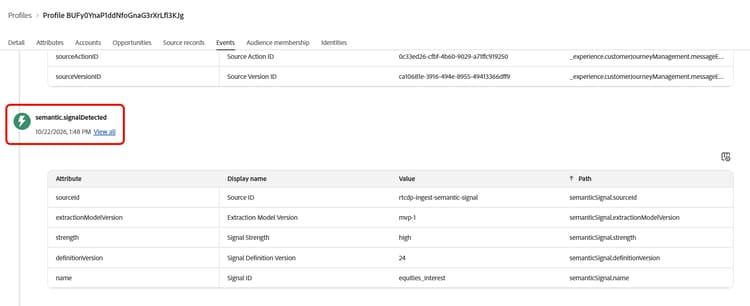
创建信号后,您可以使用受众生成器将该信号添加到受众。 这些信号将显示为体验事件。
有关使用受众生成器的更多信息,请阅读受众生成器文档。
使用信号创建受众后,即可提取使用此信号的用户档案。 检测到的信号是事件类型为semantic.signalDetected的体验事件。
常见问题 faq
以下部分列出了与包含非结构化数据的用户档案相关的常见问题。
包含非结构化数据的用户档案是否与普通客户用户档案不同?
个人资料上下文/个人资料叙述是什么?
用户档案上下文(用户档案描述)是提供给AI代理以改进交互的综合信息。 上下文可以合并以下数据:
- 轮廓属性
- 受众会员资格
- 行为历史记录
- 浏览活动
- 以前的对话
什么是信号?
信号是在非结构化交互中检测的结构化、可激活的含义表示。 信号的示例包括:
- 产品兴趣
- 取消意图
- 规定的偏好设置
- 人生事件
- 负面体验
- 行业
- 购买者角色
信号可以由营销人员定义,也可以由系统通过分析数据中发现的各个信号来创建。
信号与原始对话有何不同?
包含非结构化数据的Profile是否仅支持Brand Concierge?
可以使用哪些数据源?
支持以下源:
- Brand Concierge和非Brand Concierge对话
- WhatsApp对话
- 搜索查询
- 呼叫中心记录
- 聊天日志
- 调查
- 网络研讨会和销售电话成绩单
- 其他基于文本的交互