Componentes de sub-eventos em feeds de dados
Os componentes do sub-evento são dimensões e métricas baseadas em campos dentro de uma matriz ou mapa no esquema XDM. Eles permitem analisar dados em um nível mais granular do que o nível do evento, como os produtos individuais em uma compra. Para obter informações sobre como usar esses dados em segmentos, consulte Subeventos.
Use as informações a seguir para entender como os componentes de subeventos de campos de matriz e mapa aparecem nos feeds de dados do Customer Journey Analytics.
Entender os componentes do subevento
Componentes de sub-evento no esquema XDM
No esquema XDM, cada elemento de uma matriz (uma matriz de cadeia de caracteres ou uma matriz de objetos) é um sub-evento. Cada entrada em um campo de mapa também é um subevento, conforme descrito em Mapear campos em feeds de dados. Dimensões e métricas baseadas nos campos em um subevento são componentes do subevento.
Para exibir sub-eventos no esquema XDM na Adobe Experience Platform, selecione Esquemas e expanda um evento que contenha sub-eventos.
No exemplo a seguir, Product list items é uma matriz de objetos contendo vários componentes de subeventos.

Diferenças de sub-eventos entre o Analysis Workspace e os feeds de dados
Os componentes de sub-evento são representados de forma diferente entre o Analysis Workspace e os feeds de dados no Customer Journey Analytics.
Diferenças de sub-eventos entre o Adobe Analytics e o Customer Journey Analytics
Os dados de subeventos (como vários detalhes do produto em um único evento de compra) são exibidos de forma diferente nos feeds de dados do Customer Journey Analytics e nos feeds de dados do Adobe Analytics. A tabela a seguir compara como cada produto representa dados de subeventos.
Uma lista de produtos contém vários produtos agrupados em uma única sequência:
Power Tools;Cordless Drill;1;129.99,Power Tools;Drill Battery Pack;2;39.98
Uma lista de produtos mantém sua hierarquia que é definida no esquema XDM como uma matriz:
[{"category":"Power Tools","product":"Cordless Drill","quantity":1,"revenue":129.99},{"category":"Power Tools","product":"Drill Battery Pack","quantity":2,"revenue":39.98}]
Exemplo de sub-evento: Produtos em um evento de compra
Um cliente adquire dois produtos em um único pedido: uma furadeira sem fio e duas baterias de furadeira. Sua implementação envia um único evento de compra que inclui ambos os produtos na matriz de objetos productListItems:
{
  "eventType": "commerce.purchases",
  "timestamp": "2026-09-16T14:32:07.512Z",
  "commerce": {
    "purchases": { "value": 1 }
  },
  "productListItems": [
    { "SKU": "CD-2000", "name": "Cordless Drill", "quantity": 1, "priceTotal": 129.99 },
    { "SKU": "BP-2000", "name": "Drill Battery Pack", "quantity": 2, "priceTotal": 39.98 }
  ]
}
Este evento contém dois sub-eventos, um para cada objeto na matriz productListItems. A tabela a seguir mostra quais campos pertencem ao evento e quais pertencem a seus sub-eventos.
eventType, timestamp, commerce.purchases.value1 para este evento, independentemente de quantos produtos ela contém.SKU, name, quantity, priceTotal em cada objeto productListItemsquantity é 1 para a análise sem fio e 2 para a análise de bateria.productListItems nesse evento de compra.Adicionar componentes de subeventos a um feed de dados
Ao adicionar um componente de subevento a um feed de dados, uma caixa de diálogo solicita que você adicione os outros componentes do mesmo subevento.

Campos do mesmo subevento aparecem na tela de desenho como um grupo aninhado recolhível em vez de um item plano.
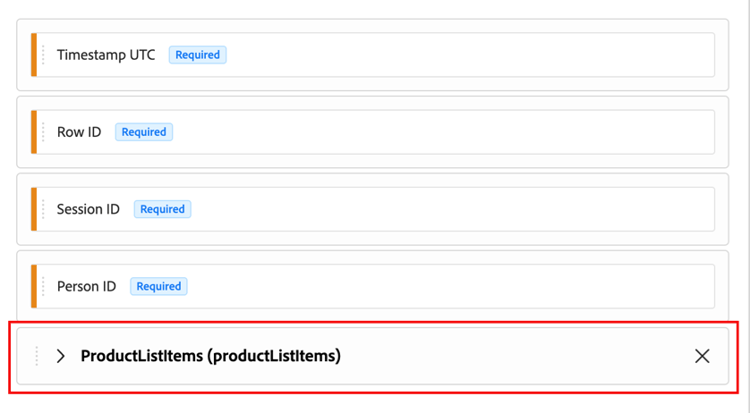
Esse grupo reflete a estrutura de dados subjacente.
Na saída do feed de dados, todos esses componentes aparecem como uma matriz aninhada em uma única coluna. Os arquivos Parquet suportam matrizes aninhadas nativamente. Para obter mais informações, consulte Trabalhar com arquivos Parquet em feeds de dados.
Para obter informações sobre como adicionar componentes, incluindo componentes de subeventos, a um feed de dados, consulte Criar um feed de dados.
Consultar dados de subeventos na saída do feed de dados
Como os dados de subeventos aparecem de forma diferente nos feeds de dados do Customer Journey Analytics, as consultas usadas para eles são diferentes daquelas usadas para os feeds de dados do Adobe Analytics.
Os exemplos a seguir mostram como localizar eventos que incluem um produto específico. Os exemplos usam a sintaxe do Google BigQuery, onde UNNEST expande uma matriz em linhas. Outros data warehouses oferecem suporte à mesma abordagem com suas próprias funções de matriz, como FLATTEN no Snowflake ou explode no Databricks.
Nos feeds de dados do Customer Journey Analytics, os mesmos dois produtos aparecem como uma matriz de objetos na coluna product_list_items. Nenhuma análise de delimitador é necessária:
| code language-json |
|---|
|
A forma como você grava a consulta depende de se você deseja uma linha por evento ou uma linha por produto correspondente.
Retornar uma linha por evento
Para filtrar eventos sem alterar o número de linhas, use uma função de matriz, como UNNEST dentro de uma subconsulta EXISTS:
| code language-sql |
|---|
|
Esta consulta retorna uma linha para cada evento correspondente, com a matriz product_list_items completa intacta, independentemente de quantos produtos na matriz sejam correspondentes.
Retornar uma linha por produto correspondente
Para retornar uma linha para cada produto correspondente, mova a função de matriz para a cláusula externa FROM:
| code language-sql |
|---|
|
Um evento com mais de um produto correspondente aparece como várias linhas, e as colunas do evento, como row_id, se repetem em cada linha. Use essa abordagem somente quando precisar de detalhes no nível do produto. Para contar eventos nos resultados, use COUNT(DISTINCT row_id) em vez de contar linhas.
Essa abordagem se aplica a qualquer campo de matriz no esquema XDM, não apenas aos produtos.
Nos feeds de dados do Adobe Analytics, um evento com dois produtos comprados juntos aparece como uma única cadeia de caracteres delimitada na coluna product_list:
| code language-text |
|---|
|
Para localizar eventos que incluem uma Análise sem Fio, analise essa string com uma expressão regular:
| code language-sql |
|---|
|
Usar campos de mapa em feeds de dados
Os campos de mapa no esquema XDM armazenam pares de valores-chave. Os feeds de dados exportam cada mapa como uma matriz de objetos, da mesma forma que outros dados de subeventos. Cada objeto contém a chave do mapa e seu valor como campos separados.
Os nomes de campos na saída vêm das IDs de componente configuradas para o feed de dados, não de nomes fixos como key ou value. Os exemplos nesta seção usam IDs de componente de exemplo.
Mapas simples
Mapas simples são o tipo de mapa que você pode criar em seu próprio esquema. Cada chave é uma string e cada valor é uma string ou um número inteiro.
Por exemplo, um mapa de pesquisa armazena cada pergunta como uma chave e a resposta como um valor:
{
  "_yourtenant": {
    "surveyResponses": {
      "How did you hear about us?": "Search engine",
      "How likely are you to recommend us?": 9
    }
  }
}
Na saída do feed de dados, survey_question e survey_answer são as IDs de componente para a chave e o valor:
{
  "survey_responses": [
    { "survey_question": "How did you hear about us?", "survey_answer": "Search engine" },
    { "survey_question": "How likely are you to recommend us?", "survey_answer": 9 }
  ]
}
Mapa de identidade
Cada identidade no campo identityMap é exportada como um objeto. O objeto contém o namespace de identidade (a chave), juntamente com o identificador, o estado autenticado e o sinalizador principal. O namespace se repete para cada identidade nesse namespace.
Somente os atributos do mapa de identidade que existem como dimensões em sua visualização de dados e que você adiciona ao feed de dados são exportados.
{
  "identity_map": [
    { "identity_namespace": "ECID", "identity_id": "83290187457380573620940587193016478103", "authenticated_state": "ambiguous", "is_primary": true },
    { "identity_namespace": "CRMID", "identity_id": "C-1048576", "authenticated_state": "authenticated", "is_primary": false }
  ]
}
Mapas aninhados
Alguns campos definidos pela Adobe, como segmentMembership, são mapas de mapas. Os feeds de dados os nivelam em uma única matriz, com a chave de primeiro nível e a chave de segundo nível como campos separados em cada objeto. A chave de primeiro nível se repete em cada objeto ao qual se aplica, de modo que nenhum dado ou relacionamento é perdido.
Por exemplo, segment_namespace e segment_id são as IDs de componente para a chave de primeiro nível e a chave de segundo nível:
{
  "segment_membership": [
    { "segment_namespace": "ups", "segment_id": "04a81716-43d6-4e7a-a49c-f1d8b3129ba9", "status": "realized" },
    { "segment_namespace": "ups", "segment_id": "53cba6b2-a23b-454a-8069-fc41308f1c0f", "status": "exited" }
  ]
}