スキーマとIDのヘルスチェック
スキーマとIDのヘルスチェックでは、スキーマとID名前空間をスキャンして、不完全なID解決、プロファイル数の増加、不正確なアクティベーションにつながるベストプラクティスの欠落や設定のミスがないか確認します。
ID フィールドの検証 identity-field-validation
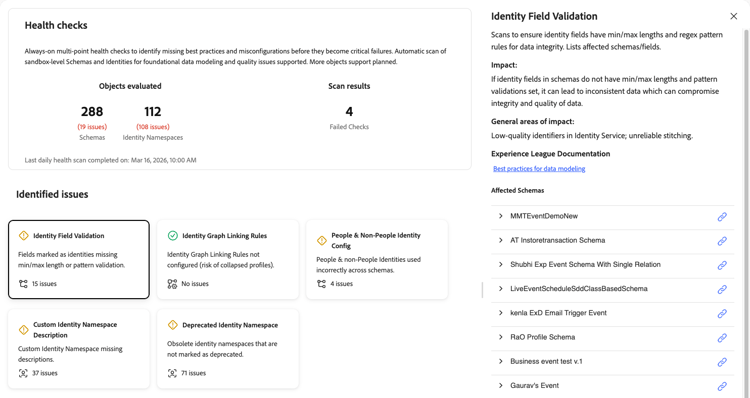
ID フィールドにデータ整合性の最小長と最大長の制約と正規表現パターンルールがあることを確認するためにスキャンします。
ID フィールド検証 カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明: ID フィールドの長さが最小/最大であること、およびデータの整合性を確保するための正規表現パターンルールを確認するためにスキャンします。 影響を受けるスキーマとフィールドのリスト。
- 影響: スキーマのID フィールドの最小値/最大値とパターン検証が設定されていない場合、データの一貫性が損なわれ、データの整合性と品質が損なわれる可能性があります。
- 一般的な影響エリア: Identity Serviceの低画質のID。信頼性のないステッチです。
- Experience League ドキュメント: データモデリングのベストプラクティスへのリンク。
- 影響を受けるスキーマ:影響を受けるスキーマのリスト。各スキーマには、詳細を表示するためのエクスパンダーと、スキーマを開くためのリンクが含まれています。
説明、影響、影響を受けるスキーマを示す
詳しくは、スキーマのベストプラクティス ドキュメントの「 データ整合性のヒント 」を参照してください。
ID グラフのリンクルール identity-graph-linking-rules
折りたたまれたプロファイルを防ぐために、ID グラフのリンク ルールがサンドボックス用に設定されていることを確認します。
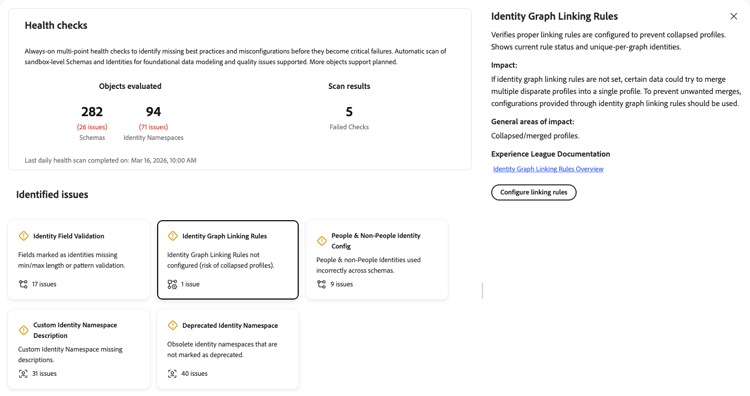
ID グラフ リンク ルール カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明:適切なリンクルールが設定されていることを確認して、壊れたプロファイルを防ぎます。 現在のルールステータスとグラフごとの一意のIDが表示されます。
- 影響: ID グラフのリンク ルールが設定されていない場合、特定のデータで、複数の異なるプロファイルを単一のプロファイルに結合しようとすることがあります。 望ましくない結合を防ぐには、ID グラフのリンクルールを通じて提供される設定を使用する必要があります。
- 一般的な影響エリア:折りたたまれたプロファイルまたは結合されたプロファイル。
- Experience League ドキュメント:詳しくは、ID グラフのリンキングルールの概要へのリンクを参照してください。
- リンクルールの設定:チェックが失敗すると、ボタンが表示され、パネルから直接リンクルールを設定できます。
説明、影響、およびリンクルールの設定ボタンを表示する
詳細については、ID グラフ リンク ルールの概要および実装ガイド を参照してください。
人物および人以外のID設定 people-non-people-identity
スキーマクラス全体で、人物および人物以外のID タイプの正しい使用を検証します。
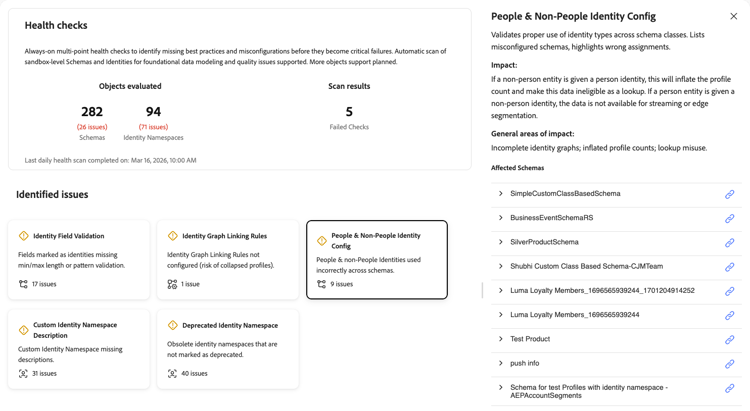
People & Non-People ID Config カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明: スキーマクラス全体でID タイプの適切な使用を検証します。 誤って設定されたスキーマを一覧表示し、誤った割り当てを強調表示します。
- 影響:人物でないエンティティに個人IDが与えられた場合、プロファイル数が増加し、このデータがルックアップとして無効になります。 個人エンティティに個人ID以外のIDが与えられた場合、そのデータはストリーミングやエッジセグメント化には使用できません。
- 一般的な影響エリア:不完全なID グラフ、プロファイル数の増加、ルックアップの誤用。
- 影響を受けるスキーマ:問題のあるスキーマのリスト。 スキーマ行を展開して、設定ミスごとにパス、ID名、スキーマタイプを確認します。 リンクアイコンを使用してスキーマを開きます。
詳しくは、ID タイプのドキュメント および スキーマのベストプラクティス を参照してください。
カスタム ID名前空間の説明 namespace-missing-description
スキャンして、カスタム ID名前空間のメタデータと説明が完了していることを確認します。
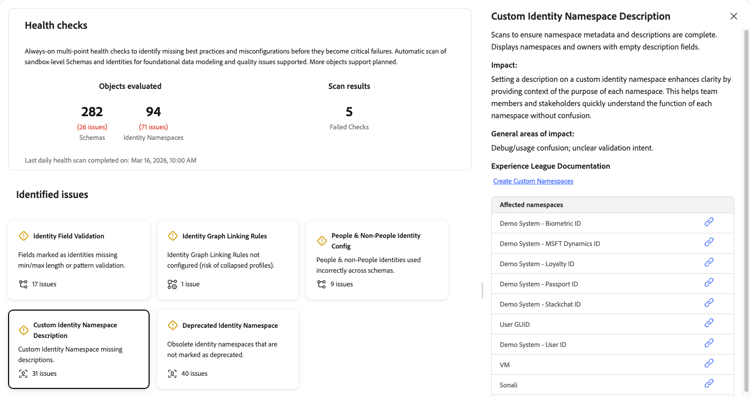
カスタム ID名前空間説明 カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明:名前空間のメタデータと説明が完了していることを確認するためにスキャンします。 空の説明フィールドを持つ名前空間と所有者を表示します。
- 影響: カスタム ID名前空間に説明を設定すると、各名前空間の目的のコンテキストが提供されるので、わかりやすくなります。 これにより、チームメンバーや関係者は、各ネームスペースの機能を混乱することなく、すばやく把握できます。
- 一般的な影響エリア: デバッグまたは使用の混乱。検証の意図が明確ではありません。
- Experience League ドキュメント:詳細については、カスタム名前空間を作成するためのリンクを参照してください。
- 影響を受ける名前空間:説明が不足しているカスタム ID名前空間のリスト。 各名前空間の横にあるリンクアイコンを使用して、表示または編集します。
詳しくは、 カスタム名前空間の作成に関するドキュメントを参照してください。
ID名前空間が使用されていません namespace-not-in-use
クリーンアップ用にマークする必要がある古いID名前空間または未使用のID名前空間を検出します。 このチェックは、以前に「非推奨のID名前空間」として文書化されていました。
使用されていないID名前空間 カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明:クリーンアップ用に古いID名前空間または未使用のID名前空間を検出します。 最後に使用したタイムスタンプまたはスキーマ参照を含む、未使用の名前空間を一覧表示します。
- 影響:どのスキーマでも使用されていないID名前空間は、名前に「非推奨」または「使用しない」タグを追加することで、削除するようにマークする必要があります。 ID名前空間の削除は現在サポートされていません。
- 一般的な影響領域:混乱とラベル変更のリスク。
- Experience League ドキュメント:詳細なドキュメントについては、廃止されたID名前空間へのリンクを参照してください。
- 影響を受ける名前空間:古いID名前空間または未使用のID名前空間のリスト。 各名前空間の横にあるリンクアイコンを使用して、表示または管理します。
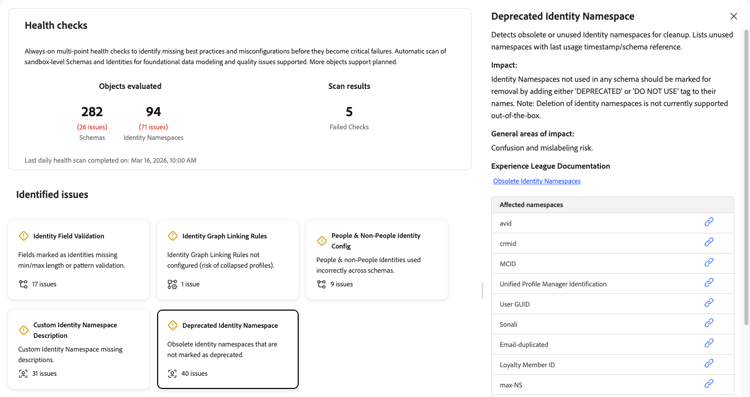
詳しくは、廃止された名前空間🔗に関するExperience Cloud ナレッジベースの記事を参照してください。
関係フィールド上の非個人ID non-person-identity-relationship-field
ID記述子と関係記述子の両方を同時に持つスキーマフィールドにフラグを付けます。
関係フィールド の人以外のID カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明: スキーマフィールドに関係記述子を配置すると、2つの別々のスキーマ間の直接的で動的な結合が確立されることを説明します。 Real-Time Customer Profile ストアとAudience Builderに、プライマリスキーマまたはソーススキーマのフィールドが、ターゲットスキーマのルックアップまたはディメンションレコードを指す外部キーとして機能することを伝えます。 このチェックは、ID記述子と同じフィールドの関係記述子の両方を持つスキーマフィールドを検査します。
- 影響:これらの記述子は相互に排他的であり、同じフィールドに両方を含めることはデータモデリングエラーです。 結果には、誤ったセグメンテーションやオーディエンスのアクティベーションが含まれる場合があります。
- 一般的な影響エリア: オーディエンスの品質。
- Experience League ドキュメント:ID用のXDM スキーマ構成へのリンク。
- 影響を受けるスキーマ:該当する場合、競合する記述子を持つフィールドを持つスキーマのリスト。 問題が検出されない場合、代わりにパネルに 合格チェック の確認が表示されます。
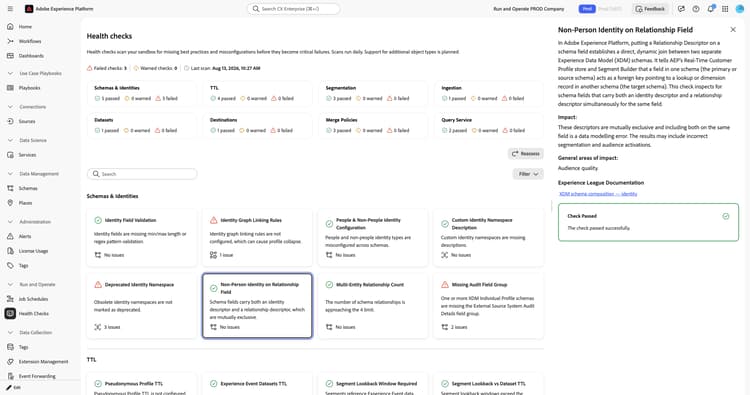
詳しくは、 スキーマ構成ドキュメント を参照してください。
複数エンティティの関係数 multi-entity-relationship-count
プラットフォームの制限に近づくと、サンドボックスで定義されたマルチエンティティ関係の数を監視します。
「Multi-Entity Relationship Count」カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明:複数のエンティティの関係が、Real-Time Customer ProfilesやExperienceEventsなどのプライマリエンティティを、商品カタログ、店舗、ビジネスアカウントなどのセカンダリディメンションエンティティにリンクすることを説明します。 このチェックは、サンドボックスで定義された5つのマルチエンティティ関係の制限を超えているかどうかを調べます。
- 影響:高い基数と過度のスキーマ結合は、Real-Time Customer Profile ストア全体で計算の複雑さを高めます。 制限を超えると、Segmentation Serviceのパフォーマンスが低下し、オーディエンス評価の遅延が増加する可能性があります。
- 一般的な影響領域: バッチセグメント化。
- Experience League ドキュメント: データモデリングのベストプラクティスへのリンク。
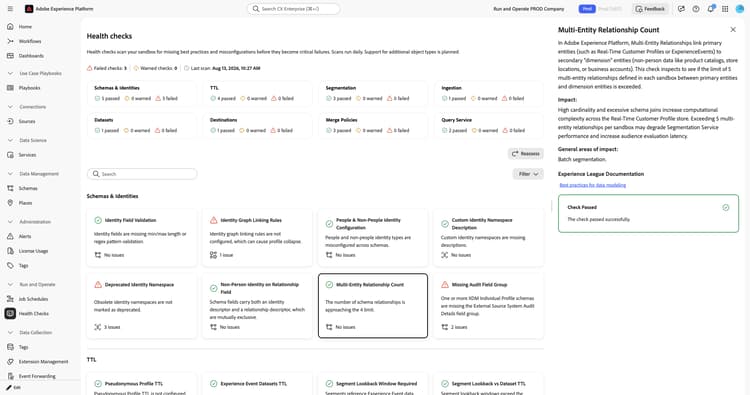
詳しくは、 データモデリングのベストプラクティス および複数エンティティのセグメント化チュートリアル を参照してください。
監査フィールドグループがありません missing-audit-field-group
XDM Individual Profile スキーマにExternal Source System Audit Details フィールドグループが含まれていることを確認します。
環境にない監査フィールドグループ カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明: XDM個人プロファイルスキーマに、レコードの出所と更新タイムスタンプのトラッキングに必要な外部Source System Audit Details フィールドグループが含まれていることを確認します。
- 影響:監査フィールドがないと、データがExperience Platformに取り込まれたタイミングに関するレコードレベルの可視性がありません。そのため、古いレコードや重複したレコードのトラブルシューティングが困難になります。
- 一般的な影響エリア:外部データの変更を監査できません。
- Experience League ドキュメント:外部Source System監査詳細フィールドグループへのリンク。
- Recommendation:見つからない場合は、外部Source System Audit Details フィールドグループを追加します。
- 影響を受けるスキーマ: フィールドグループが見つからないスキーマのリスト。 各スキーマの横にあるリンクアイコンを使用して開きます。
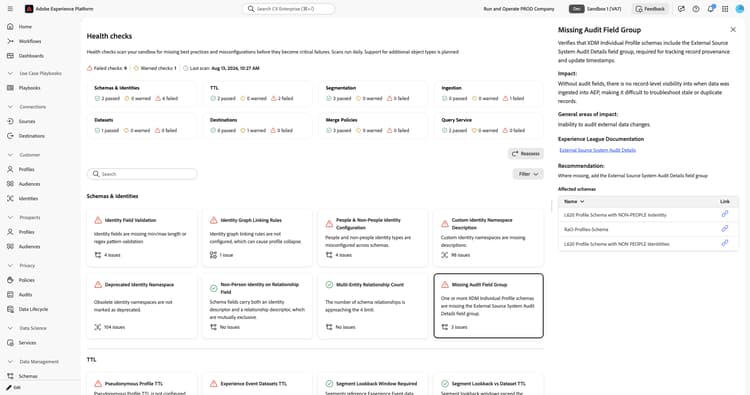
詳細については、外部Source System Audit Details フィールドグループのドキュメント を参照してください。
プライマリIDの一意性 primary-identity-uniqueness
ID名前空間をプライマリ IDとして使用する方法と、ID グラフのリンクルールで定義する方法を比較します。
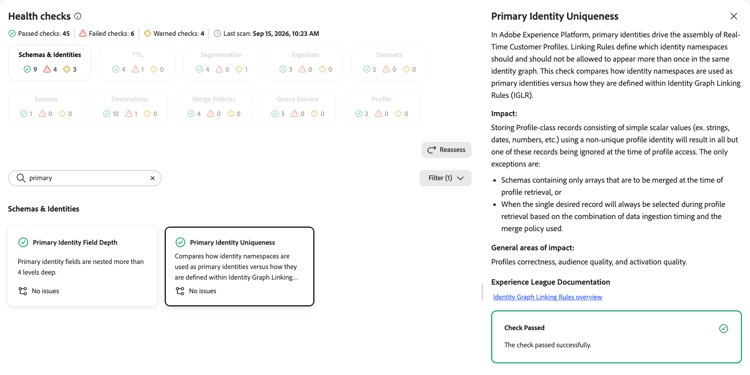
プライマリ IDの一意性 カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明:プライマリ IDがReal-Time Customer Profilesのアセンブリを促進することを説明します。 リンクルールは、同じID グラフに複数回表示できるID名前空間を定義します。 このチェックは、ID名前空間がプライマリ IDとして使用される方法と、ID グラフのリンクルール内でどのように定義されるかを比較します。
- 影響:一意でないプロファイル IDを使用して、単純なスカラー値を持つプロファイルクラスレコードを保存すると、プロファイルアクセス時に1つを除くすべてのレコードが無視されます。 2つの例外が適用されます。結合された配列のみを含むスキーマと、取り込みタイミングと結合ポリシーに基づいて目的のレコードが常に選択されるケースです。
- 一般的な影響領域: プロファイルの正確性、オーディエンスの品質、アクティベーションの品質。
- Experience League ドキュメント:ID グラフ リンク ルールの概要へのリンク。
説明、影響、および一般的な影響エリアを示す
詳細については、ID グラフ リンク ルールの概要を参照してください。
マルチレベルの関係 multi-level-relationships
2次元スキーマ間で誤って定義された関係を検出します。
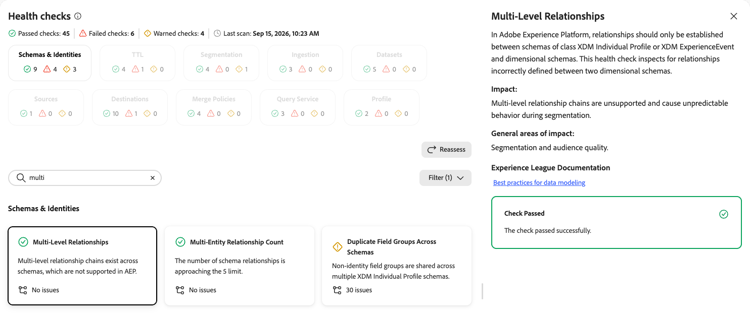
マルチレベル関係 カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明:関係は、XDM Individual Profile クラスまたはXDM ExperienceEvent クラスのスキーマとディメンション スキーマの間でのみ確立する必要があることを説明します。 このチェックでは、2次元スキーマ間で誤って定義された関係を調べます。
- 影響:マルチレベルの関係チェーンはサポートされておらず、セグメント化の際に予期しない動作が発生します。
- 一般的な影響エリア:セグメンテーションとオーディエンスの品質。
- Experience League ドキュメント: データモデリングのベストプラクティスへのリンク。
詳しくは、 データモデリングのベストプラクティス を参照してください。
プライマリ ID フィールドの深さ primary-identity-field-depth
プライマリ ID フィールドがスキーマフィールド階層に深くネストされていないことを確認します。
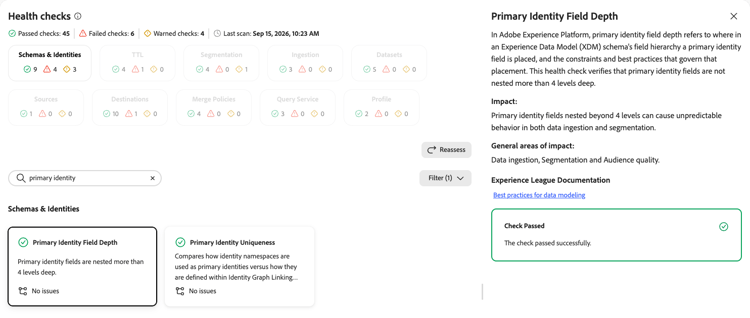
「プライマリ ID フィールドの深度」カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明: プライマリ ID フィールドの深さは、XDM スキーマのフィールド階層内のどこにプライマリ ID フィールドが配置され、その配置を管理する制約とベストプラクティスを指すことを説明します。 このチェックは、プライマリ ID フィールドが4つのレベルを超えてネストされていないことを確認します。
- 影響: プライマリ ID フィールドが4つのレベルを超えてネストされていると、データの取り込みとセグメント化の両方で予測不可能な動作が発生する可能性があります。
- 一般的な影響領域: データの取り込み、セグメンテーション、オーディエンスの品質。
- Experience League ドキュメント: データモデリングのベストプラクティスへのリンク。
説明、影響、および一般的な影響エリアを示す
詳しくは、 データモデリングのベストプラクティス を参照してください。
スキーマ間でのフィールドグループの複製 duplicate-field-groups-across-schemas
複数のスキーマをまたいでアクティブな非ID フィールドグループを検出します。
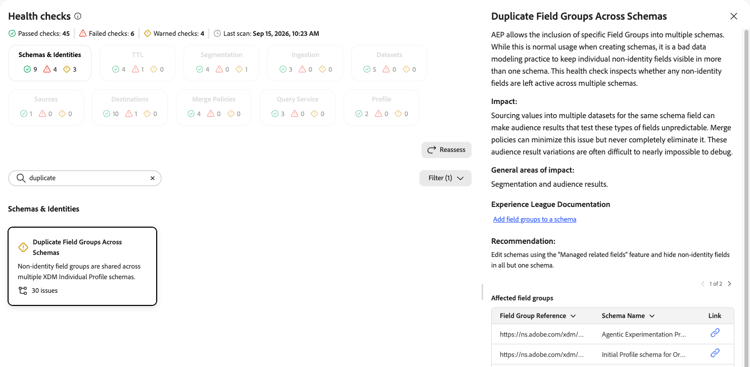
「スキーマ間でフィールドグループを複製」カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明: Experience Platformでは、特定のフィールドグループを複数のスキーマに含めることができることを説明します。 スキーマを作成する場合は、通常このような方法を使用しますが、複数のスキーマで個別のID以外のフィールドを表示し続けるのは、データモデリングの誤った方法です。 このチェックは、複数のスキーマでID以外のフィールドがアクティブのままになっているかどうかを調べます。
- 影響:同じスキーマフィールドの複数のデータセットに値をソーシングすると、これらのフィールドをテストするオーディエンスの結果が予測不可能になる場合があります。 結合ポリシーは、この問題を最小限に抑えることができますが、完全に排除することはできず、結果として生じるバリエーションはデバッグが困難になることがよくあります。
- 一般的な影響エリア: セグメンテーションとオーディエンスの結果。
- Experience League ドキュメント: スキーマにフィールドグループを追加するためのリンク。
- 推奨事項:管理された関連フィールド機能を使用してスキーマを編集し、1つのスキーマを除くすべてのスキーマでID以外のフィールドを非表示にします。
- 影響を受けるフィールドグループ: フィールドグループの参照とスキーマ名を含む、スキーマ間で共有されるフィールドグループのリスト。 リンクアイコンを使用してスキーマを開きます。
詳細については、 スキーマへのフィールドグループの追加を参照してください。
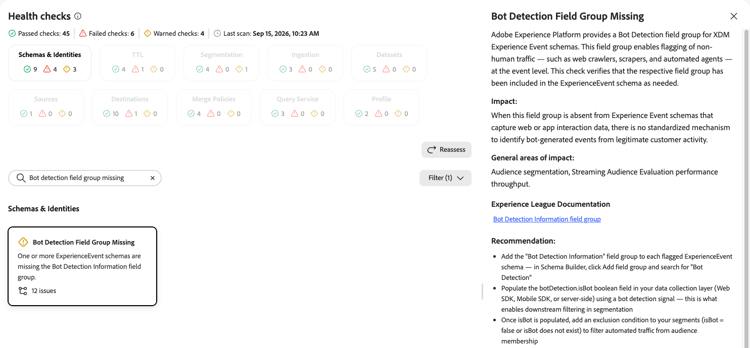
ボット検出フィールドグループがありません bot-detection-field-group-missing
ExperienceEvent スキーマにボット検出情報フィールドグループが含まれていることを確認します。
botDetection.isBot ブール値フィールドを入力し、セグメントからボットを除外します。「ボット検出フィールドグループが見つかりません」カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明: Experience PlatformがXDM ExperienceEvent スキーマのボット検出フィールドグループを提供することを説明します。 このフィールドグループを使用すると、web web クローラー、スクレイパー、自動エージェントなど、人以外のトラフィックをイベントレベルでフラグ付けできます。 このチェックは、フィールドグループが必要に応じてExperienceEvent スキーマに含まれていることを確認します。
- 影響:このフィールドグループが、webまたはアプリのインタラクションデータをキャプチャするExperienceEvent スキーマに存在しない場合、ボット生成イベントを正当な顧客アクティビティから識別するための標準化されたメカニズムはありません。
- 一般的な影響エリア: オーディエンスのセグメンテーションとストリーミングオーディエンスの評価パフォーマンスのスループット。
- Experience League ドキュメント: Bot Detection Information フィールドグループへのリンク。
- Recommendation: フラグが設定された各ExperienceEvent スキーマにボット検出情報フィールドグループを追加します。 ボット検出信号を使用して
botDetection.isBotフィールドに入力し、ボットをセグメントから除外します。
説明、影響、および一般的な影響エリアを示す
詳しくは、 ボット検出情報フィールドグループのドキュメント を参照してください。
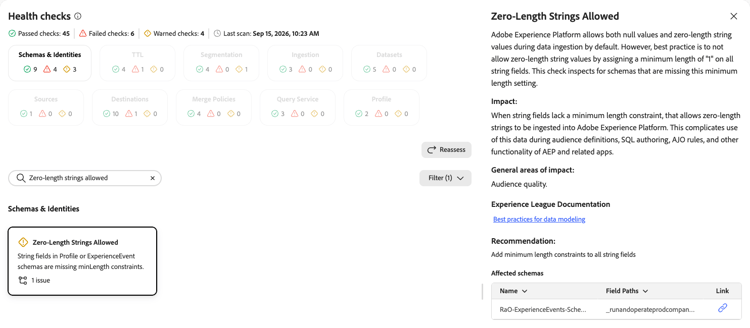
長さが0の文字列は許可されています zero-length-strings-allowed
文字列フィールドに最低1文字の長さが必要であることを確認します。
長ゼロ文字列許可 カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明: データ取り込み中にExperience Platformがnull値とゼロ長の文字列値の両方をデフォルトで許可することを説明します。 ベストプラクティスは、すべての文字列フィールドに1つ以上の長さを割り当てることで、長さが0の文字列値を許可しないことです。 このチェックでは、この最小長の設定が欠落しているスキーマを調べます。
- 影響:文字列フィールドに最小長の制約がない場合、長さが0の文字列を取り込むことができるため、オーディエンスの定義、SQL オーサリング、Adobe Journey Optimizer ルールおよびその他の機能でのデータの使用が複雑になります。
- 一般的な影響エリア: オーディエンスの品質。
- Experience League ドキュメント: データモデリングのベストプラクティスへのリンク。
- 推奨事項:すべての文字列フィールドに最小長の制約を追加します。
- 影響を受けるスキーマ:影響を受けるスキーマとフィールドパスのリスト。 リンクアイコンを使用してスキーマを開きます。
詳しくは、 データモデリングのベストプラクティス を参照してください。
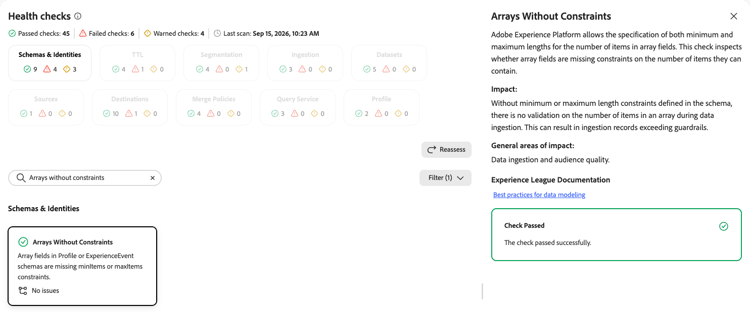
制約のない配列 arrays-without-constraints
配列フィールドで最小値と最大値の項目制約が定義されていることを確認します。
制約のない配列 カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明: Experience Platformでは、配列フィールドの項目数について、最小長と最大長の両方を指定できることを説明します。 このチェックは、配列フィールドに含めることができる項目数に関する制約が欠落しているかどうかを調べます。
- 影響: スキーマで定義された最小長または最大長の制約がないと、データ取り込み中に配列内の項目数に対する検証が行われず、取り込みレコードがガードレールを超える可能性があります。
- 一般的な影響領域: データの取り込みとオーディエンスの品質。
- Experience League ドキュメント: データモデリングのベストプラクティスへのリンク。
詳しくは、 データモデリングのベストプラクティス を参照してください。
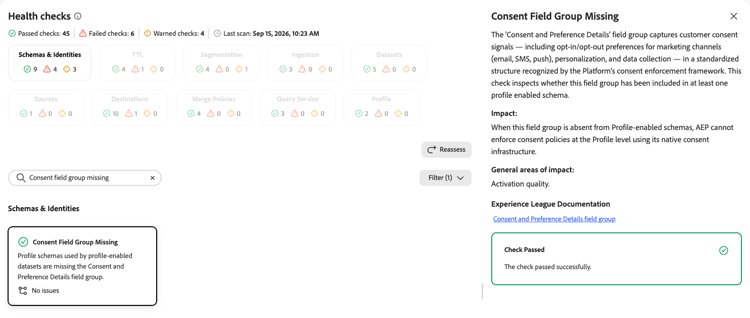
同意フィールドグループがありません consent-field-group-missing
プロファイルが有効になっているスキーマに、同意と環境設定の詳細フィールドグループが含まれていることを確認します。
「同意フィールドグループがありません」カードを選択すると、右側に詳細パネルが開きます。 パネルには次の内容が表示されます。
- 説明:同意と環境設定フィールドグループが、マーケティングチャネル、パーソナライゼーション、データ収集に対するオプトインおよびオプトアウトの環境設定などの顧客の同意シグナルを、標準化された構造でキャプチャすることを説明します。 このチェックは、フィールドグループが少なくとも1つのプロファイル対応スキーマに含まれているかどうかを調べます。
- 影響:このフィールドグループがプロファイル対応スキーマに含まれていない場合、Experience Platformは、ネイティブの同意インフラストラクチャを使用して、プロファイルレベルで同意ポリシーを適用できません。
- 一般的な影響エリア: アクティベーションの品質。
- Experience League ドキュメント:同意と環境設定フィールドグループへのリンク。
詳しくは、同意と環境設定フィールドグループのドキュメント を参照してください。
次の手順 next-steps
- ヘルスチェックの概要に戻って、その他のチェックカテゴリを確認します。
- 信頼性の高いデータモデルを設計するための スキーマのベストプラクティス について説明します。
- プロファイルの折りたたみを防ぐため、ID グラフ リンク ルール について理解します。
- 名前空間管理のベストプラクティスについては、ID名前空間ドキュメント を確認してください。