非構造化データを使用したリアルタイムの顧客プロファイルにより、顧客との会話をパーソナライズし、顧客の意図を活性化できます
Adobe Experience Platformでは、複数チャネルからのデータをリアルタイムの顧客プロファイルと組み合わせることで、顧客データを統合ビューに集約することができます。 非構造化データを含むリアルタイム顧客プロファイルは、会話形式などのテキストベースの顧客データを利用して、既存の顧客プロファイルを拡張できます。 これにより、顧客向けの担当者は、設定されたプロファイルコンテキストと会話履歴を使用して、オーディエンスの選定と下流のパーソナライゼーションのためのシグナルを定義できます。
非構造化データを使用したプロファイルの理解 understanding
現在、Adobe Real-Time CDPは、オンライン、オフライン、CRM、サードパーティなど、複数のチャネルからの構造化データを統合し、それらのデータを統合された顧客像にまとめています。これにより、あらゆる顧客とのやり取りについて、実用的なタイムスタンプ付きのアカウントを提供できます。 ただし、これは非構造化データの取り込みをカバーするものではなく、会話、文字起こし、またはその他のマルチモーダルデータ(PDFや画像など)からのデータはプロファイルで使用できません。
非構造化データを使用したプロファイルにより、会話などのテキストベースの顧客データを顧客のコンテキストやシグナル抽出に利用でき、サポートされているエージェントやチャネルをまたいでインタラクションをパーソナライズできます。
非構造化データを含むプロファイルは、Experience Platformのお客様に次の機能を提供します。
- 顧客の意図を理解する:会話、メッセージ、検索クエリ、通話記録、アンケート、その他のテキストベースのインタラクションを取り込んで、既存の顧客プロファイルを充実させます。
- 会話のパーソナライズ: プロファイル属性、オーディエンスメンバーシップ、会話履歴を組み合わせることで、Brand Conciergeや他のカスタマーサービス担当者が、エージェント、セッション、デバイス、チャネルをまたいで、パーソナライズされたエクスペリエンスを継続的に提供できるようにします。
- リアルタイムでインテントをアクティブ化:会話からマーケター定義のシグナルを抽出し、オーディエンス、ジャーニー、パーソナライゼーションを通じてアクティブ化します。 これらのダウンストリームアクティベーションは、Adobe Journey OptimizerやTargetを含むExperience Platform全体で使用できます。
ユースケース use-cases
非構造化データを使用したプロファイルでは、会話データをアクティベーションシグナルとして使用してエンゲージメントを促進し、インバウンドパーソナライゼーションやアウトバウンドアクティベーションをより簡単に推進できます。 これにより、これらのプロファイルをさまざまなユースケースで使用できます。
会話型パーソナライゼーション
シグナルの抽出と活性化
連続性
サンプルフロー sample-flow
アパレルとアウトドアウェアを販売するretailerを検討しましょう。
この例では、Johnがretailerのサイトを訪問し、AI エージェントを使用してトレーニングウェアのレコメンデーションを求めます。 Johnさんがログインしているので、非構造化データを含むプロファイルは、ゴールドロイヤルティ層、アクティブウェアの好み、アウトドアスポーツへの興味など、設定された顧客コンテキストを提供できます。 担当者は、このコンテキストを使用して、推奨事項をさらにカスタマイズできます。
ジョンは「私はハーフマラソンのトレーニングをしているし、朝は凍てつくような風が強い。 私は過熱することなく暖かく保つことができる何かが必要です。 担当者は、Johnの述べたニーズと既存の嗜好を組み合わせて、軽量で風に強いランニングジャケットなどの適切なアパレルを推奨できるようになりました。
さらに、Experience Platformでは、非構造化データを含むプロファイルを使用して、マーケターが定義した「アウトドアパフォーマンス」インテントシグナルを会話から検出します。 その結果、このシグナルにより、Johnは「アウトドアパフォーマンスの意図」オーディエンスの資格を得ることができ、その後のパーソナライズされた体験をサポートすることができます。
例えば、retailerでは、「Outdoor Performance Intent」オーディエンスを使用して、Johnがweb サイトに戻ったときに寒い天候のトレーニングのオファーを示したり、Adobe Journey Optimizerなどのアプリケーションを通じてパーソナライズされたメールを送信したりすることができます。 適切なオーディエンスとジャーニーを設定すれば、このメールでは、関連するランニングアパレルと、ゴールドメンバーへのダブルポイントオファーの両方を特集できます。
Betaの前提条件 prerequisites
非構造化データでプロファイルを使用するには、は次の前提条件を満たしている必要があります。
- 既に既存のReal-Time CDPまたはAdobe Journey Optimizer ユーザー
- notさんはHealthcare Shield アドオンを使用しています
これらの前提条件をすべて満たしている場合は、非構造化データを含むプロファイルのイネーブルメントをリクエストする方法について詳しくは、Adobe カスタマーケアにお問い合わせください。
要件 requirements
非構造化データを設定してプロファイルを続行する前に、次の手順を完了する必要があります。
- ID グラフ リンク ルール を有効にする
- プロファイル対応データセットを作成し、少なくとも1つのプロファイルをこのデータセットに取り込みます
- これにより、非構造化データを含むプロファイルがプロファイルストーリーを作成します。 このデータセットは、会話やその他の非構造化データが取り込まれるデータセットとは 別の です。
非構造化データを含むプロファイルを有効にしたら、次の手順を設定してこの機能を使用できます。
- Experience Platformへの非構造化データの取り込み
- 会話をパーソナライズするためのプロファイルコンテキストの設定
- 非構造化データからデータを抽出し、アクティベーションするためのシグナルを設定できます
非構造化データの取り込み ingest
パーソナライゼーションプロセスの一環として非構造化データを使用するには、まずExperience Platformにそのデータを取り込む必要があります。
非構造化データの取り込み方法は、非構造化データのソースによって異なります。
生のテキストを使用した標準のシンプル IDのユースケースでは、ExperienceEvent スキーマとデータセットを使用して、データをExperience Platformに取り込むことができます。 これは、トランスクリプト、会話、メモ、レビューの読み込みなど、ほとんどのユースケースに最適です。
スキーマの作成
| note important |
|---|
| IMPORTANT |
| プロファイルの非構造化データスキーマを not 有効にします。 プロファイルやID用の非構造化データデータセットなどです。 |
まず、データセットのXDM ExperienceEvent スキーマを作成する必要があります。 このスキーマには、次の情報を含める必要があります。
unstructuredContentフィールドグループ。 非構造化コンテンツフィールドグループについて詳しくは、XDM GitHubを参照してください。- 既知の個人をマークするID。 このIDは、ID マップまたはID記述子としてマークされたフィールドのいずれかです。
スキーマの作成方法については、 スキーマの作成ガイド を参照してください。
データセットの作成
| note important |
|---|
| IMPORTANT |
| プロファイルまたはIDの非構造化データ データセットを not 有効にします。 |
スキーマを作成した後、このスキーマを使用するデータセットを作成できます。 既存のスキーマに基づいてデータセットを作成する方法については、 データセットの作成ガイド を参照してください。
データセットを作成したら、新しく作成したデータセットのIDを指定しながら、v2/dataSets エンドポイントに対してPATCH リクエストを行うことができます。 これにより、非構造化データを含むプロファイルで使用するデータセットを更新できます。
| accordion | ||||
|---|---|---|---|---|
| 非構造化データを含むプロファイルのデータセットを有効にするためのパッチ要求と応答のサンプル。 | ||||
応答が成功すると、新しく更新されたデータセットのIDを含むHTTP ステータス 200が返されます。
|
データを取得
これで、スキーマとデータセットが設定されたので、Experience Platformへのデータの取り込みを開始できます。 CSV、JSON、Parquetはすべてサポートされているため、標準のソースコネクタを使用してデータをExperience Platformに読み込むことができます。 データを取り込む際に、非構造化テキストをrawText フィールドに入力し、IDをidentity列に入力します。
組織ID、サンドボックス情報、データセット情報、取り込み方法(生のテキスト XDMを含む単純なID)などの情報をAdobe カスタマーケアに問い合わせて、データ取り込みの設定を完了できるようになりました。
| note availability |
|---|
| AVAILABILITY |
| WhatsApp コネクタは クローズ済みベータ です。 |
WhatsApp コネクタの設定方法については、WhatsApp コネクタガイド を参照してください。
WhatsApp コネクタを設定すると、WhatsAppWebhook Raw Event データセットが自動的に作成されます。 このデータセットは、チャネル情報も適用された非構造化データを含むプロファイルに対して自動的に有効になります。
WhatsApp コネクタを設定した後、Adobe カスタマーケアに、組織ID、サンドボックス情報、チャネル (WhatsApp Business)、およびモード (ストリーミングまたはバッチ)などの情報を問い合わせて、非構造化データを含むプロファイルに使用するコネクタを許可リストに加えるします。
Brand Conciergeの会話では、ユーザープロンプト、エージェントの応答、フィードバックを追跡する3つのデータセットが自動的に作成されます。
非構造化データを含むプロファイルでこれらのデータセットを有効にするには、3つのデータセットのそれぞれのIDを指定しながら、v2/dataSets エンドポイントに対してPATCH リクエストを行う必要があります。
| accordion | ||||
|---|---|---|---|---|
| 非構造化データを含むプロファイルのデータセットを有効にするためのパッチ要求と応答のサンプル。 | ||||
応答が成功すると、新しく更新されたデータセットのIDを含むHTTP ステータス 200が返されます。
|
プロファイルコンテキストの設定
非構造化データをExperience Platformに取り込んだ後は、プロファイルコンテキストを設定して、会話のパーソナライズに役立てることができます。 このプロファイルストーリーは、CoworkerまたはExperience Platform APIを使用して設定できます。
Coworker内で「セマンティックプロファイル設定を作成したい」と尋ねることで、設定を開始できます。
Coworkerは、次の手順を実行して、非構造化データを使用してプロファイルを設定する手順をガイドします。
-
同僚は「ユースケースは何か」と尋ねます?
-
ユースケースを説明したら、Coworkerはユースケースに基づいて、関連属性のリストを提供します
-
属性が正常に表示されることを確認したら、Coworkerが残りの設定オプションを案内します。 デフォルトでは、設定には no 個のオーディエンス説明があり、precise個のプロファイルナラティブを使用し、no個のマーケティングアクションラベルを使用し、default個のユーザー名前空間を使用します。
- オーディエンスの説明をプロファイルストーリーに追加して
- オーディエンスの説明を含めると、プロファイルがそのオーディエンスに適格である場合に、プロファイルのストーリーにコンテキストが追加されます。 オーディエンスの説明を追加すると、パーソナライゼーションを受け取る顧客をnot フィルタリングします。
- プロフィールストーリーの正確さ
- マーケティング活動は
- 使用されるユーザー名前空間
- オーディエンスの説明をプロファイルストーリーに追加して
これらの手順を実行すると、非構造化データコンテキストを含むプロファイルが作成されます。
Experience Platform APIを使用して、非構造化データコンテキストを使用してプロファイルを設定できます。
続行する前に、関連ドキュメントへのリンク、このセクションのサンプル API呼び出しを読むためのガイド、任意のExperience Platform APIを正常に呼び出すために必要なヘッダーに関する重要な情報については、入門ガイド をお読みください。
カテゴリを取得 get-categories
まず、プロファイルのコンテキストのカテゴリを取得する必要があります。 カテゴリは、サンドボックスで使用可能なプロファイル属性のグループです。
API 形式
| code language-http |
|---|
|
リクエスト
次のリクエストは、サンドボックス内で使用可能なすべてのカテゴリとその属性のリストを取得します。
| accordion | ||
|---|---|---|
| 使用可能なカテゴリを取得するためのサンプルリクエスト。 | ||
|
応答
応答が成功すると、組織とサンドボックスで使用可能なカテゴリのリストを含むHTTP ステータス 200が返されます。
| accordion | ||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 組織とサンドボックスに属するカテゴリと属性のリストを含むサンプル応答 | ||||||||||||||||||||
|
設定の作成
サンドボックスで使用可能なカテゴリを取得したら、設定を作成できます。 この設定には、プロファイルデータのカテゴリと属性、強調表示するオーディエンス、マーケティングアクション、ストーリーの精度、名前空間が含まれます。
API 形式
| code language-http |
|---|
|
リクエスト
次のリクエストでは、指定されたオーディエンス、マーケティングアクションなし、ファジーなストーリー精度、メール名前空間などの顧客デモグラフィックカテゴリを使用して、非構造化データ設定のプロファイルを作成します。
| accordion | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| プロファイル設定を作成するためのサンプルリクエスト。 | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|
応答
応答が成功すると、HTTP ステータス 200が一意のリクエスト IDと、新しく作成した設定の詳細で返されます。
| accordion | ||
|---|---|---|
| 新しく作成された設定を含むサンプル応答。 | ||
|
プロファイルコンテキストが作成されたので、Brand Conciergeまたはその他のカスタマーサービス担当者に対して設定を保存できます。
Brand Conciergeのプロファイルコンテキスト profile-context-brand-concierge
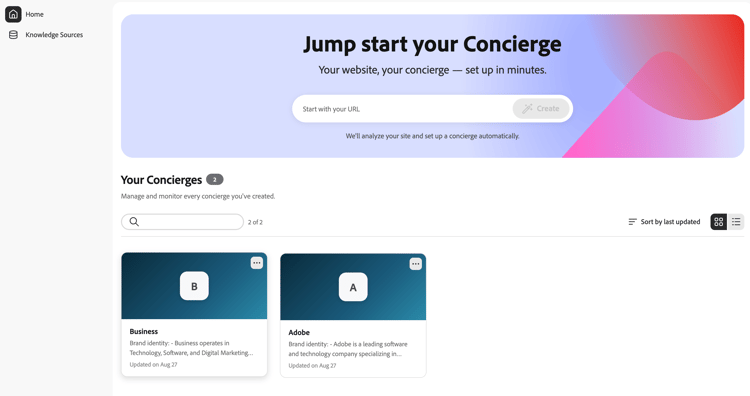
Brand Conciergeで、プロファイル設定を適用するコンシェルジュを選択します。
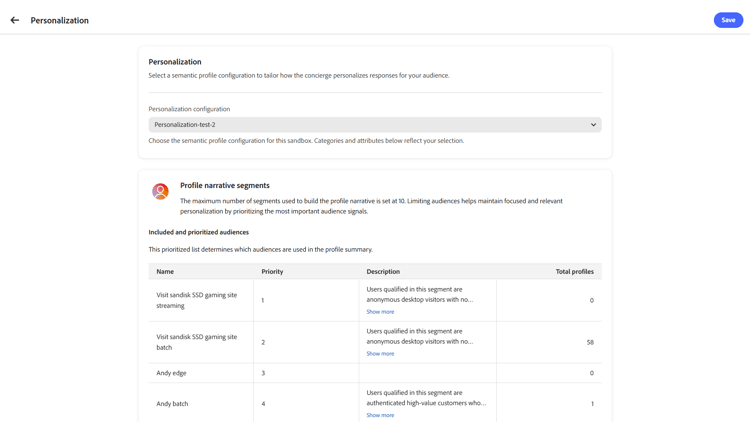
コンシェルジュを選択したら、Personalization タブに移動し、以前に作成したコンフィギュレーションを選択して、Saveを選択し、プロファイル コンフィギュレーションを適用します。
他の顧客向けエージェントとのプロファイルコンテキスト profile-context-other
他の顧客向けエージェントとプロファイルコンテキストを使用するには、Experience Platform APIを使用して顧客のプロファイルコンテキストを検索し、会話履歴を取得する必要があります。 これらの両方の値を取得することで、エージェントは会話を開始する前に、完全で関連するコンテキストを適切に取得できます。
顧客のプロファイルコンテキストを検索するには、entityIdNS、entityId、configurationNameをクエリパラメーターとして提供しながら、/semanticprofile/lookup/narrative エンドポイントにGET リクエストを行う必要があります。
| code language-shell |
|---|
|
| table 0-row-2 1-row-2 2-row-2 3-row-2 | |
|---|---|
| クエリパラメーター | 説明 |
entityIdNS |
ID名前空間。 これは、サンドボックスで定義された名前空間である必要があります。 使用可能な値には、Email、ECIDおよびCRMIDが含まれます。 |
entityId |
名前空間内のID値。 予約済み文字をエンコードするURLを 必ず してください。 例えば、探している電子メールがjohn+1@example.comの場合、これはjohn%2B1@example.comと書く必要があります。 |
configurationName |
以前に作成した設定の名前。 |
応答が成功すると、プロファイルコンテキストに関する情報を含むHTTP ステータス 200が返されます。
| code language-json |
|---|
|
| table 0-row-2 1-row-2 2-row-2 | |
|---|---|
| フィールド | 説明 |
requestId |
リクエストに対して生成された一意のID。 |
narrative |
生成された自然言語プロファイルの概要。 |
顧客の以前の会話履歴を検索するには、entityIdNSとentityIdをクエリパラメーターとして提供しながら、/semanticprofile/query/v1/profile エンドポイントに対してPOST リクエストを行う必要があります。
| code language-shell |
|---|
|
| table 0-row-2 1-row-2 2-row-2 | |
|---|---|
| クエリパラメーター | 説明 |
entityIdNS |
ID名前空間。 これは、サンドボックスで定義された名前空間である必要があります。 使用可能な値には、Email、ECIDおよびCRMIDが含まれます。 |
entityId |
名前空間内のID値。 予約済み文字をエンコードするURLを 必ず してください。 |
| リクエストフィールド | タイプ | 説明 |
| ------------- | -------- | ---- | ----------- |
| conversations | オブジェクト | 会話に関する情報を返すかどうかを決定するオブジェクト。 空のオブジェクトのままにすると、インタラクション、メタデータ、シグナルに関する情報が自動的に受信されます。 |
サンプル応答は、要求されたエンティティの会話に関する情報を含むHTTP ステータス 200を返します。
| code language-json |
|---|
|
ストーリーと会話の両方を入手した後、この情報をサードパーティのAI エージェントに提供することができます。 その結果、AI エージェントは、顧客が誰であるかだけでなく、顧客が話し合った内容に関する情報も入手できます。
データ抽出のためのシグナルの設定 configure-signals
プロファイルコンテキストを設定すると、非構造化データからデータを抽出するシグナルを設定できるようになります。
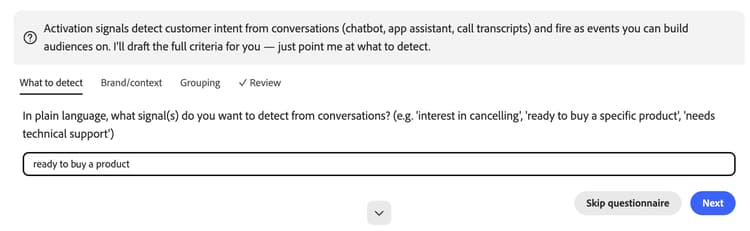
このプロセスは、Coworkerに移動し、「会話からシグナルを抽出してみましょう」と尋ねることで開始できます。 続いて、チームメンバーは、会話から検出するシグナルのタイプを尋ねます。
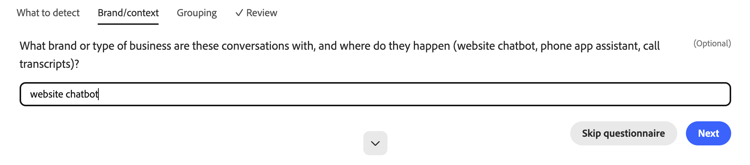
次に、チームメンバーは、会話がどのタイプのブランドやビジネスの一部なのかを尋ねます。
最後に、同僚が新しいシグナルグループを作成するか、既存のシグナルグループに追加するかを尋ねます。
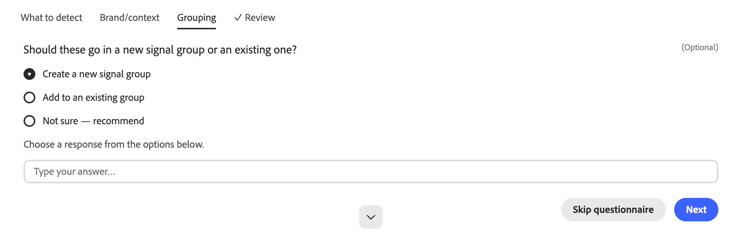
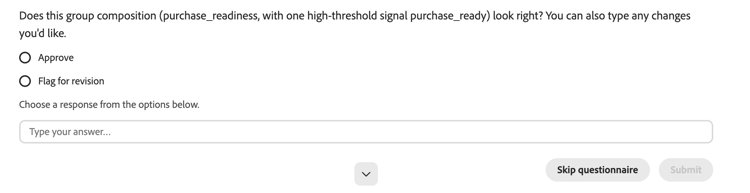
次に、上記の手順が正確に表示されるかどうか、および信号作成を続行する場合は、確認できます。
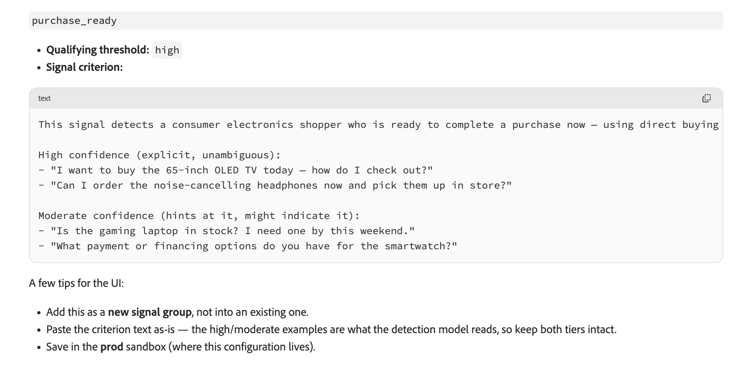
信号の作成が始まります。 パートナーはシグナルを作成し、自動的にExperience Platformに追加されます。
シグナルを作成したら、Audience Builderを使用してシグナルをオーディエンスに追加できます。 シグナルは、エクスペリエンスイベントとして表示されます。
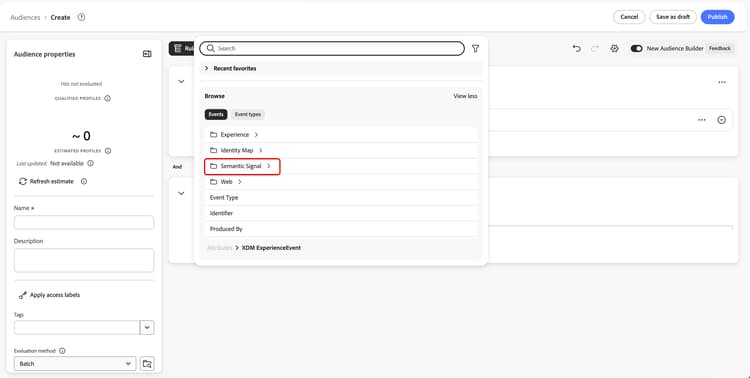
オーディエンスビルダーの使用について詳しくは、 オーディエンスビルダーのドキュメント を参照してください。
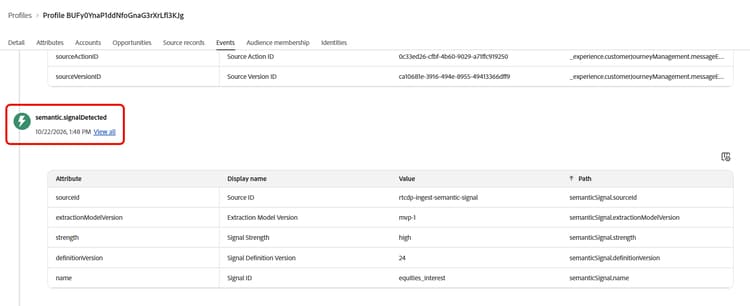
シグナルを含むオーディエンスを作成したら、このシグナルを使用するプロファイルを抽出できます。 検出されたシグナルはエクスペリエンスイベントで、イベントタイプはsemantic.signalDetectedです。
よくある質問 faq
次の節では、非構造化データを含むプロファイルに関するよくある質問を示します。
非構造化データを含むプロファイルは、通常の顧客プロファイルとは別のものですか?
プロファイルのコンテキスト/プロファイルのストーリーとは何ですか?
プロファイルコンテキスト(プロファイルストーリー)は、インタラクションを改善するためにAI エージェントに提供される統合情報です。 コンテキストは、次のデータを組み合わせることができます。
- プロファイル属性
- オーディエンスのメンバーシップ
- 行動履歴
- 閲覧行動
- 以前の会話
シグナルとは?
シグナルとは、非構造化インタラクション内で検出される、構造化されたアクティベーション対応の意味の表現です。 シグナルの例には次のようなものがあります。
- 製品への関心
- 解約の意図
- 設定された環境設定
- ライフイベント
- ネガティブな体験
- 業界
- 購入者の役割
シグナルは、マーケターが定義することも、データ内で発見された個々のシグナルを分析することでシステムが作成することもできます。
シグナルと生の会話はどのように異なりますか?
非構造化データを含むプロファイルは、Brand Conciergeのみをサポートしますか?
どのデータソースを使用できますか?
次のソースがサポートされています。
- Brand ConciergeとBrand Concierge以外
- WhatsAppとの会話
- 検索クエリー
- コールセンターでの文字起こし
- チャットログ
- 調査
- ウェビナーおよびセールス電話での文字起こし
- その他のテキストベースのインタラクション