Personnaliser les conversations client à l’aide du profil client en temps réel avec des données non structurées
Dans Adobe Experience Platform, vous pouvez consolider vos données client en une vue unifiée en combinant des données issues de plusieurs canaux avec le profil client en temps réel. Grâce à la prise en charge des données non structurées, Experience Platform étend ces fonctionnalités et vous permet d’utiliser sémantiquement des données client conversationnelles et autres données client non structurées dans le cadre des blocs de création de profil.
Comprendre le profil avec des données non structurées understanding
Le profil client en temps réel combine actuellement des données structurées issues de plusieurs canaux, notamment des données en ligne, hors ligne, CRM et tierces, les consolidant en une vue unifiée qui offre un compte horodaté et exploitable de chaque interaction client. Cependant, cela ne couvre pas l’ingestion de données non structurées, ce qui signifie que les données provenant de conversations, de transcriptions ou d’autres données multimodales (telles que des PDF ou des images) ne sont pas disponibles pour être utilisées avec Profile.
Un profil avec des données non structurées vous permet d’accéder à des données non traitées, ce qui vous permet de mieux personnaliser les conversations, car le contexte client continuera à être partagé sur plusieurs plateformes, y compris Brand Concierge.
Un profil avec des données non structurées fournit les fonctionnalités suivantes aux clients Experience Platform :
- Comprendre l’intention du client : ingérez des conversations, des messages, des requêtes de recherche, des transcriptions d’appels, des questionnaires et d’autres interactions textuelles pour enrichir le profil client existant.
- Personnaliser les conversations : combinez les attributs de profil, l’appartenance à l’audience et l’historique des conversations afin que Brand Concierge et d’autres agents orientés client puissent offrir des expériences personnalisées avec une continuité entre les agents, les sessions, les appareils et les canaux.
- Activer l’intention en temps réel : extrayez les signaux définis par les spécialistes marketing des conversations et activez-les par le biais des audiences, des parcours et de la personnalisation. Ces activations en aval peuvent être utilisées dans Experience Platform, y compris Adobe Journey Optimizer et Target.
Cas d’utilisation use-cases
Un profil avec des données non structurées vous permet d’utiliser des données conversationnelles comme signal d’activation pour d’autres engagements, ce qui vous permet de piloter plus facilement des personnalisations entrantes et des activations sortantes. Par conséquent, vous pouvez utiliser ces profils dans divers cas d’utilisation :
- Activation en fonction des intérêts : en tant qu’entreprise de vente au détail, un acheteur authentifié mentionne une préférence alimentaire dans sa conversation. Le signal extrait les qualifie pour une audience d’intérêt « sans gluten », qui peut être utilisée pour l’activation entrante et sortante, telles que les offres et les parcours personnalisés.
- Suppression d’expérience négative : en tant que société de vente au détail « big-box », la frustration est détectée dans la conversation d’un client ou d’une cliente. Ce client est ensuite supprimé d’une audience promotionnelle pour éviter d’envoyer un message sortant sourd.
- Routage basé sur l’intention et personnalisation de la session suivante : en tant que société de services financiers ou de technologie financière, un client mentionne un événement personnel (tel que « marié », « déménagé » ou « nouvel emploi ») dans une conversation. Ces mots-clés sont extraits et utilisés pour personnaliser leur prochaine session afin de mettre le client en relation avec un conseiller possédant l’expertise pertinente en matière de domaine.
Exemple de flux sample-flow
Prenons l’exemple d’une entreprise qui offre des services financiers à ses clients.
Dans ce scénario, l’un de vos clients interroge un agent au sujet des actions. Puisque ce client est connecté, votre agent connaît cet utilisateur en lisant son profil client en temps réel.
Ce client poursuit ensuite la conversation en disant : « J’avais aussi l’intention de m’asseoir et de vraiment revoir mon épargne-retraite, mais je n’ai pas encore pris le temps de la planifier. » En utilisant Profile avec des données non structurées, Brand Concierge et Experience Platform peuvent extraire l’intention de ces conversations, ce qui vous permet d’envoyer des réponses personnalisées par le biais de l’agent.
Par conséquent, Experience Platform peut demander à ce client de rejoindre l’audience « Intérêt pour la planification financière » et personnaliser immédiatement l’agent pour lui répondre : « Veillons à ce que votre plan de retraite soit en bonne voie - Réservez un enregistrement gratuit auprès d’Alex Agent ».
En outre, comme ce contexte est partagé par toutes les applications Experience Platform, vous pouvez poursuivre la conversation sur la suppression dans plusieurs formulaires. Par exemple, Adobe Journey Optimizer peut envoyer automatiquement au client un e-mail contenant une invitation à l’enregistrement de départ à la retraite avec Alex Agent.
Conditions préalables requises pour Beta prerequisites
Pour utiliser Profile avec des données non structurées, vous devez respecter les conditions préalables suivantes :
- Déjà un utilisateur Adobe Experience Platform
- Ne pas module complémentaire Healthcare Shield
Si vous remplissez toutes ces conditions préalables, contactez l’assistance clientèle d’Adobe pour plus d’informations sur la demande d’activation de Profile avec des données non structurées.
Conditions requises requirements
Avant de poursuivre Profile avec la configuration des données non structurées, vous devez effectuer les étapes suivantes :
- Activer Règles de liaison de graphiques d’identités
- Créer un jeu de données activé pour le profil
- Ingérer au moins un profil dans ce jeu de données
Une fois que le profil avec des données non structurées a été activé, vous pouvez commencer à utiliser cette fonctionnalité en configurant les étapes suivantes :
- Ingestion de données non structurées dans Experience Platform
- Configurer le contexte du profil pour personnaliser les conversations
- Configurer des signaux pour extraire des données de données non structurées en vue de leur activation
Ingestion de données non structurées ingest
Pour utiliser des données non structurées dans le cadre de votre processus de personnalisation, vous devez d’abord les ingérer dans Experience Platform.
La méthode d’ingestion des données non structurées diffère en fonction de la source des données non structurées.
Pour le cas d’utilisation standard d’identité simple avec texte brut , vous pouvez utiliser un schéma ExperienceEvent et un jeu de données pour ingérer les données dans Experience Platform. Il est recommandé de l’utiliser pour la plupart des cas d’utilisation, y compris l’importation de transcriptions, de conversations, de notes et de révisions.
Création d’un schéma
| note important |
|---|
| IMPORTANT |
| Lorsque vous créez le schéma et le jeu de données, ne les activez pas que ce soit pour Profil ou Identité. |
Vous devez d’abord créer un schéma XDM ExperienceEvent pour le jeu de données. Ce schéma doit inclure les informations suivantes :
- Le groupe de champs
unstructuredContent. Pour plus d’informations sur le groupe de champs de contenu non structuré, consultez le XDM GitHub. - Identité permettant de marquer l’individu connu. Il peut s’agir d’un mappage d’identités ou d’un champ marqué comme descripteur d’identité.
Pour savoir comment créer un schéma, consultez le guide Créer un schéma.
Créer un jeu de données
Après avoir créé le schéma, vous pouvez créer un jeu de données qui utilise ce schéma. Pour savoir comment créer un jeu de données basé sur un schéma existant, consultez le guide créer un jeu de données.
Une fois le jeu de données créé, vous pouvez envoyer une requête PATCH au point d’entrée v2/dataSets tout en fournissant l’identifiant du jeu de données nouvellement créé. Vous pouvez ainsi mettre à jour le jeu de données à utiliser avec Profil avec des données non structurées.
| accordion | ||||
|---|---|---|---|---|
| Exemple de requête et de réponse de correctif pour activer le jeu de données pour Profil avec données non structurées. | ||||
Une réponse réussie renvoie le statut HTTP 200 avec l’identifiant du jeu de données que vous venez de mettre à jour.
|
Ingérer des données
Maintenant que le schéma et le jeu de données sont configurés, vous pouvez commencer à ingérer des données dans Experience Platform. Vous pouvez utiliser un connecteur source standard pour charger les données dans Experience Platform, car CSV, JSON et Parquet sont tous pris en charge. Lors de l’ingestion des données, placez le texte non structuré dans le champ rawText et l’identité dans la colonne identity.
Vous pouvez désormais contacter l’assistance clientèle d’Adobe pour obtenir des informations telles que l’ID d’organisation, les informations sur le sandbox, les informations sur le jeu de données et la méthode d’ingestion (ID simple avec XDM en texte brut) afin de terminer la configuration de l’ingestion des données.
| note availability |
|---|
| AVAILABILITY |
| Le connecteur WhatsApp est en version bêta fermée. |
Pour savoir comment configurer le connecteur WhatsApp, lisez le guide WhatsApp guide du connecteur.
Lorsque vous configurez le connecteur WhatsApp, le jeu de données WhatsAppÉvénement brut Webhook est automatiquement créé. Ce jeu de données est automatiquement activé pour les profils avec des données non structurées ; les informations de canal sont également appliquées.
Après avoir configuré le connecteur WhatsApp, contactez l’assistance clientèle d’Adobe avec des informations telles que l’identifiant de l’organisation, les informations sur le sandbox, le canal (WhatsApp Business) et le mode (diffusion en continu ou par lots) pour placer sur la liste autorisée le connecteur à utiliser pour le profil avec des données non structurées.
Pour les conversations Brand Concierge, trois jeux de données qui effectuent le suivi des invites, des réponses de l’agent et des commentaires de l’utilisateur sont automatiquement créés.
Pour activer ces jeux de données pour Profil avec des données non structurées, vous devez envoyer une requête PATCH au point d’entrée v2/dataSets tout en fournissant l’identifiant de chacun des trois jeux de données.
| accordion | ||||
|---|---|---|---|---|
| Exemple de requête et de réponse de correctif pour activer le jeu de données pour Profil avec données non structurées. | ||||
Une réponse réussie renvoie le statut HTTP 200 avec l’identifiant du jeu de données que vous venez de mettre à jour.
|
Configuration du contexte du profil
Après l’ingestion de données non structurées dans Experience Platform, vous pouvez configurer le contexte du profil pour personnaliser vos conversations. Vous pouvez configurer ce récit de profil à l’aide de Coworker ou des API d’Experience Platform.
Vous pouvez commencer la configuration en demandant « Je souhaite créer une configuration de profil sémantique » dans Coworker.
Coworker vous guidera tout au long des étapes de configuration de Profile avec des données non structurées en procédant comme suit :
-
Un collègue demandera « Quel est votre cas d’utilisation » ?
-
Après avoir décrit votre cas d’utilisation, Coworker fournira une liste d’attributs pertinents, en fonction du cas d’utilisation
-
Une fois que vous avez confirmé que les attributs semblent corrects, Coworker confirmera les actions suivantes. Par défaut, Coworker n’aura aucune description d’audience, précis récit de profil, aucune étiquette de gouvernance des données et l’espace de noms de personne par défaut.
- Si vous souhaitez ajouter les descriptions d’audience au récit du profil
- La précision du récit du profil
- Ajouter des libellés de gouvernance des données et définir l’espace de noms de la personne
Après avoir suivi ces étapes, votre profil avec contexte de données non structuré est créé.
Vous pouvez configurer le profil avec un contexte de données non structuré à l’aide des API d’Experience Platform.
Avant de poursuivre, lisez le guide de prise en main pour obtenir des liens vers la documentation associée, un guide de lecture des exemples d’appels API dans cette section et des informations importantes sur les en-têtes requis pour réussir des appels vers n’importe quelle API Experience Platform.
Obtenir les catégories get-categories
Vous devrez d’abord obtenir les catégories pour le contexte Profil . Les catégories sont des regroupements d’attributs de profil disponibles dans votre sandbox.
Format d’API
| code language-http |
|---|
|
Requête
La requête suivante récupère une liste de toutes les catégories disponibles et de leurs attributs dans votre sandbox.
| accordion | ||
|---|---|---|
| Exemple de requête pour récupérer les catégories disponibles. | ||
|
Réponse
Une réponse réussie renvoie un état HTTP 200 avec une liste des catégories disponibles pour votre organisation et votre sandbox.
| accordion | ||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Exemple de réponse contenant une liste des catégories et attributs appartenant à votre organisation et à votre sandbox | ||||||||||||||||||||
|
Création d’une configuration
Après avoir obtenu les catégories disponibles pour votre sandbox, vous pouvez créer une configuration. La configuration contient les catégories et attributs des données de profil, les audiences que vous souhaitez mettre en évidence, les actions marketing, la précision narrative, ainsi que l’espace de noms.
Format d’API
| code language-http |
|---|
|
Requête
La requête suivante crée un profil avec une configuration de données non structurée à l’aide de la catégorie Démographies des clients , y compris une audience spécifiée, aucune action marketing, une précision narrative floue et un espace de noms d’e-mail.
| accordion | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Exemple de requête pour créer une configuration de profil. | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|
Réponse
Une réponse réussie renvoie le statut HTTP 200 avec un identifiant de requête unique et les détails de la configuration que vous venez de créer.
| accordion | ||
|---|---|---|
| Exemple de réponse contenant la configuration nouvellement créée. | ||
|
Maintenant que le contexte du profil a été créé, vous pouvez enregistrer la configuration sur Brand Concierge ou tout autre agent face au client.
Contexte du profil dans Brand Concierge profile-context-brand-concierge
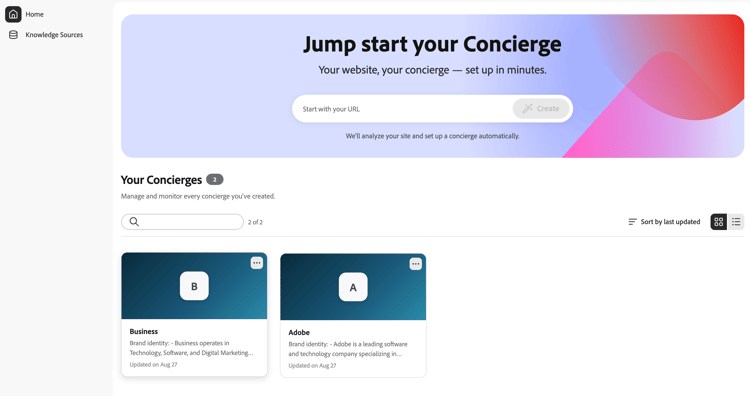
Dans Brand Concierge, sélectionnez le concierge auquel vous souhaitez appliquer la configuration de profil.
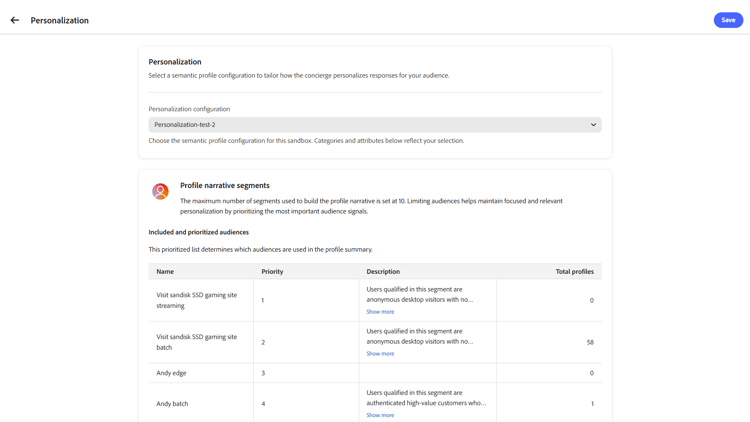
Une fois que vous avez sélectionné le concierge, accédez à l’onglet et sélectionnez la configuration créée précédemment.
Contexte du profil avec d’autres agents orientés clients profile-context-other
Pour utiliser le contexte du profil avec d’autres agents orientés client, vous devez utiliser l’API Experience Platform pour rechercher le contexte du profil du client et récupérer l’historique des conversations. En récupérant ces deux valeurs, votre agent peut récupérer correctement le contexte complet et pertinent avant de démarrer une conversation.
Pour rechercher le contexte du profil du client, vous devez effectuer une requête GET au point d’entrée /semanticprofile/lookup/narrative tout en fournissant les entityIdNS, entityId et configurationName comme paramètres de requête.
| code language-shell |
|---|
|
| table 0-row-2 1-row-2 2-row-2 3-row-2 | |
|---|---|
| Paramètre de requête | Description |
entityIdNS |
Espace de noms d’identité. Il doit s’agir d’un espace de noms défini dans votre sandbox. Les valeurs possibles sont Email, ECID et CRMID. |
entityId |
Valeur d’identité dans l’espace de noms. Vous devez l’URL encode les caractères réservés. |
configurationName |
Nom de la configuration créée précédemment. |
Une réponse réussie renvoie un état HTTP 200 avec des informations sur le contexte du profil.
| code language-json |
|---|
|
| table 0-row-2 1-row-2 2-row-2 | |
|---|---|
| Champ | Description |
requestId |
ID unique généré pour la requête. |
narrative |
Résumé du profil en langage naturel généré. |
Pour rechercher l’historique des conversations précédentes d’un client ou d’une cliente, vous devez envoyer une requête POST au point d’entrée /semanticprofile/query/v1/profile, tout en fournissant les entityIdNS et entityId comme paramètres de requête.
| code language-shell |
|---|
|
| table 0-row-2 1-row-2 2-row-2 | |
|---|---|
| Paramètre de requête | Description |
entityIdNS |
Espace de noms d’identité. Il doit s’agir d’un espace de noms défini dans votre sandbox. Les valeurs possibles sont Email, ECID et CRMID. |
entityId |
Valeur d’identité dans l’espace de noms. Vous devez l’URL encode les caractères réservés. |
| Champ de requête | Type | Description |
| ------------- | -------- | ---- | ----------- |
| conversations | Objet | Objet qui détermine si vous souhaitez renvoyer des informations sur les conversations. En le laissant comme un objet vide, vous recevrez automatiquement des informations sur les interactions, les métadonnées et les signaux. |
Un exemple de réponse renvoie un état HTTP 200 avec des informations sur les conversations pour l’entité demandée.
| code language-json |
|---|
|
Après avoir obtenu le récit et les conversations, vous pouvez transmettre ces informations à vos agents d’IA tiers. Par conséquent, l’agent d’IA disposera d’informations sur la personne qui est le client, ainsi que d’informations sur ce dont le client a discuté.
Configuration des signaux pour extraire des données configure-signals
Une fois que vous avez configuré le contexte du profil, vous pouvez configurer des signaux pour extraire des données de vos données non structurées.
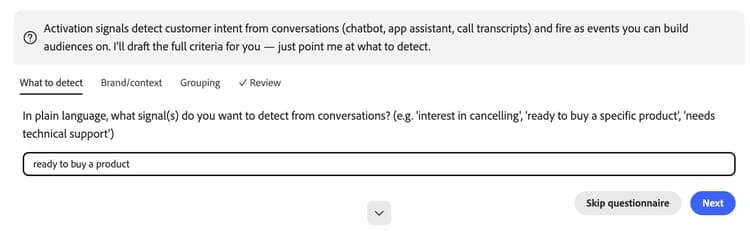
Vous pouvez commencer ce processus en allant chez Coworker et en demandant « Laissez-moi extraire les signaux des conversations ». Un collègue demande ensuite quel type de signaux vous souhaitez détecter dans les conversations.
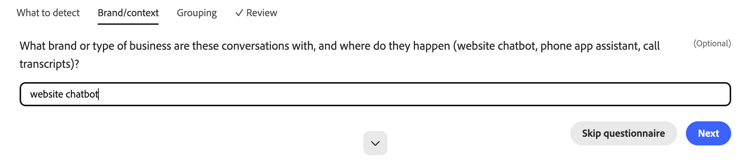
Ensuite, Coworker demande de quel type de marque ou d’entreprise ces conversations font partie.
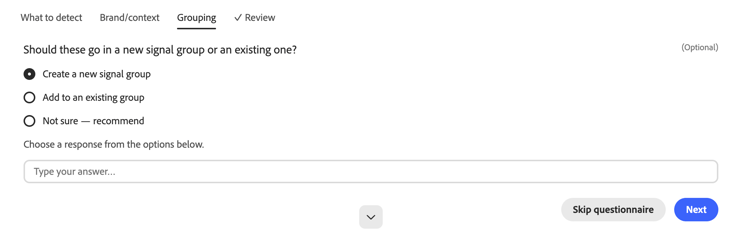
Enfin, Coworker vous demande si vous souhaitez créer un nouveau groupe de signaux ou si vous souhaitez l’ajouter à un groupe de signaux existant.
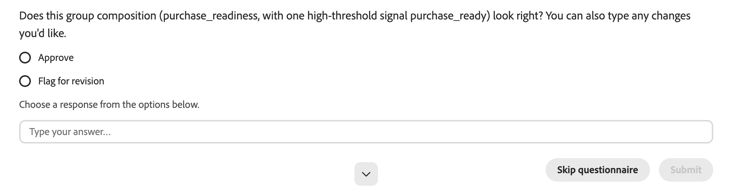
Vous pouvez ensuite vérifier si les étapes ci-dessus semblent exactes et si vous souhaitez poursuivre la création du signal.
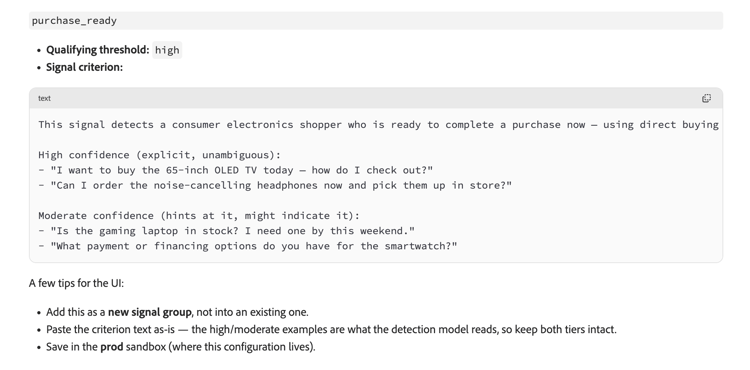
La création du signal commence. Coworker crée ensuite un signal qui est automatiquement ajouté à Experience Platform.
Questions fréquentes faq
La section suivante répertorie les questions fréquentes relatives aux profils avec des données non structurées.
Les profils contenant des données non structurées sont-ils distincts d’un profil client normal ?
Quel est le contexte/le récit du profil ?
Le contexte du profil (récit du profil) est l’information consolidée fournie à un agent d’IA pour améliorer une interaction. Le contexte peut combiner les données suivantes :
- Attributs de profil
- Appartenance à une audience
- Histoire comportementale
- Activité de navigation
- Conversations précédentes
Qu’est-ce qu’un signal ?
Un signal est une représentation structurée, prête pour l’activation, de la signification détectée dans une interaction non structurée. Voici quelques exemples de signaux :
- Intérêt du produit
- Intention d’annulation
- Une préférence déclarée
- Un événement personnel
- Une expérience négative
- Une industrie
- Un rôle d’acheteur
Les signaux peuvent être définis par les spécialistes du marketing ou créés par le système en analysant les signaux individuels découverts dans les données.
En quoi un signal diffère-t-il de la conversation brute ?
Un profil avec des données non structurées prend-il uniquement en charge Brand Concierge ?
Quelles sources de données puis-je utiliser ?
Les sources suivantes sont prises en charge :
- Conversations Brand Concierge et hors Brand Concierge
- Conversations WhatsApp
- Requêtes de recherche
- Transcriptions du centre d’appel
- Journaux de conversation
- Questionnaires
- Transcriptions des webinaires et des appels de vente
- Autres interactions textuelles