Personalizar conversas com os clientes usando o Perfil do cliente em tempo real com dados não estruturados
No Adobe Experience Platform, você pode consolidar os dados do cliente em uma visualização unificada combinando dados de vários canais com o Perfil do cliente em tempo real. Com suporte para dados não estruturados, o Experience Platform estende esses recursos, semanticamente permitindo que você use dados conversacionais e outros dados não estruturados do cliente como parte dos blocos de construção do perfil.
Noções básicas sobre perfis com dados não estruturados understanding
Atualmente, o Perfil do cliente em tempo real combina dados estruturados de vários canais, incluindo online, offline, CRM e de terceiros, consolidando esses dados em uma visualização unificada que oferece uma conta acionável e com carimbo de data e hora de cada interação com o cliente. No entanto, isso não abrange a assimilação de dados não estruturados, o que significa que os dados de conversas, transcrições ou outros dados multimodais (como PDFs ou imagens) não estão disponíveis para serem usados com o Perfil.
Perfil com dados não estruturados permite que você tenha acesso a dados não processados, o que permite personalizar melhor as conversas, já que o contexto do cliente continuará a ser compartilhado em várias plataformas, incluindo o Brand Concierge.
O perfil com dados não estruturados fornece os seguintes recursos aos clientes da Experience Platform:
- Entenda a intenção do cliente: assimilar conversas, mensagens, consultas de pesquisa, transcrições de chamadas, pesquisas e outras interações baseadas em texto para enriquecer o perfil do cliente existente.
- Personalizar conversas: combine atributos de perfil, associação de público-alvo e histórico de conversas para que a Brand Concierge e outros agentes voltados para o cliente possam oferecer experiências personalizadas com continuidade entre agentes, sessões, dispositivos e canais.
- Ativar intenção em tempo real: extraia sinais definidos pelo profissional de marketing de conversas e ative-os por meio de públicos, jornadas e personalização. Essas ativações downstream podem ser usadas em toda a Experience Platform, incluindo o Adobe Journey Optimizer e o Target.
Casos de uso use-cases
Perfil com dados não estruturados permite usar dados conversacionais como um sinal de ativação para mais engajamentos, o que permite direcionar personalizações de entrada e ativações de saída com mais facilidade. Como resultado, você pode usar esses perfis em vários casos de uso:
- Ativação baseada em interesses: como um negócio de varejo, um comprador autenticado menciona uma preferência dietética na conversa. O sinal extraído os qualifica para um público-alvo de interesse “livre de glúten”, que pode ser usado para ativação de entrada e saída, como ofertas e jornadas personalizadas.
- Supressão de experiência negativa: como uma grande empresa de varejo, a frustração é detectada na conversa de um cliente. Esse cliente é suprimido de um público-alvo promocional para evitar o envio de uma mensagem de saída para surdez de tom.
- Personalização da próxima sessão e do roteamento com base em intenções: como serviço financeiro ou empresa de tecnologia financeira, um cliente menciona um evento de vida (como “casado”, “estados movidos” ou “novo trabalho”) em uma conversa. Essas palavras-chave são extraídas e usadas para personalizar sua próxima sessão para corresponder o cliente a um consultor que tenha a experiência relevante no domínio.
Fluxo de amostra sample-flow
Considere uma empresa que oferece serviços financeiros a clientes.
Neste cenário, um de seus clientes pergunta a um agente sobre ações. Como esse cliente está conectado, seu agente sabe sobre esse usuário lendo o Perfil do cliente em tempo real.
Este cliente, em seguida, continua a conversa afirmando: “Eu também estava querendo me sentar e realmente rever minhas economias de aposentadoria, apenas não consegui programá-lo.” Ao usar o Perfil com dados não estruturados, o Brand Concierge e o Experience Platform podem extrair a intenção dessas conversas, o que permite enviar respostas personalizadas por meio do agente.
Como resultado, a Experience Platform pode fazer com que esse cliente entre no público-alvo de “Interesse de planejamento financeiro” e personalizar imediatamente o agente para responder com “Vamos garantir que seu plano de aposentadoria esteja no caminho certo — reserve um check-in gratuito com o Alex Agent”.
Além disso, como esse contexto é compartilhado entre todos os aplicativos do Experience Platform, você pode continuar a conversa de aposentadoria em vários formulários. Por exemplo, o Adobe Journey Optimizer pode enviar automaticamente ao cliente um email com um convite de check-in de aposentadoria com o Alex Agent.
Pré-requisitos do Beta prerequisites
Para usar o Perfil com dados não estruturados, você deve atender aos seguintes pré-requisitos:
- Já é um usuário do Adobe Experience Platform
- não possui o complemento Healthcare Shield
Se você atender a todos esses pré-requisitos, entre em contato com o Atendimento ao cliente da Adobe para obter mais informações sobre como solicitar a ativação do Perfil com dados não estruturados.
Exigências requirements
Antes de continuar com o Perfil com a configuração de dados não estruturados, você precisará concluir as seguintes etapas:
- Habilitar Regras de Vinculação do Gráfico de Identidade
- Criar um conjunto de dados habilitado para perfil
- Assimilar pelo menos um perfil neste conjunto de dados
Depois que o Perfil com dados não estruturados for ativado, você poderá começar a usar esse recurso configurando as seguintes etapas:
- Assimilar dados não estruturados no Experience Platform
- Configurar o contexto do perfil para personalizar conversas
- Configurar sinais para extrair dados de dados não estruturados para ativação
Assimilar dados não estruturados ingest
Para usar dados não estruturados como parte de seu processo de personalização, primeiro será necessário assimilar esses dados na Experience Platform.
O método para assimilar dados não estruturados difere, dependendo da origem dos dados não estruturados.
Para a identidade simples padrão com caso de uso de texto bruto, é possível usar um esquema e um conjunto de dados ExperienceEvent para assimilar os dados no Experience Platform. Isso é melhor usado para a maioria dos casos de uso, incluindo importação de transcrições, conversas, notas e revisões.
Criar um esquema
| note important |
|---|
| IMPORTANT |
| Ao criar o esquema e o conjunto de dados, não habilite-os para Perfil ou Identidade. |
Primeiro, será necessário criar um esquema XDM ExperienceEvent para o conjunto de dados. Este schema precisa incluir as seguintes informações:
- O grupo de campos
unstructuredContent. Para obter mais informações sobre o grupo de campos de conteúdo não estruturado, consulte o GitHub XDM. - Uma identidade para marcar o indivíduo conhecido. Essa identidade pode ser um mapa de identidade ou um campo marcado como o descritor de identidade.
Para saber como criar um esquema, leia o guia Criar um esquema.
Criar um conjunto de dados
Após criar o esquema, você pode criar um conjunto de dados que use esse esquema. Para saber como criar um conjunto de dados com base em um esquema existente, leia o guia Criar um conjunto de dados.
Depois de criar o conjunto de dados, você pode fazer uma solicitação PATCH para o ponto de extremidade v2/dataSets enquanto fornece a ID do conjunto de dados recém-criado. Isso permite atualizar o conjunto de dados para uso com o Perfil com dados não estruturados.
| accordion | ||||
|---|---|---|---|---|
| Exemplo de solicitação e resposta de patch para habilitar o conjunto de dados para o Perfil com dados não estruturados. | ||||
Uma resposta bem-sucedida retorna o status HTTP 200 com a ID do conjunto de dados recém-atualizado.
|
Assimilar dados
Agora que o esquema e o conjunto de dados estão configurados, você pode começar a assimilar dados na Experience Platform. Você pode usar um conector de origem padrão para carregar os dados no Experience Platform, pois há suporte para CSV, JSON e Parquet. Ao assimilar os dados, coloque o texto não estruturado no campo rawText e a identidade na coluna identity.
Agora você pode entrar em contato com o Atendimento ao cliente da Adobe com informações como ID da organização, informações da sandbox, informações do conjunto de dados e método de assimilação (ID simples com XDM de texto bruto) para concluir a configuração da assimilação de dados.
| note availability |
|---|
| AVAILABILITY |
| O conector WhatsApp está em beta fechado. |
Para saber como configurar o conector WhatsApp, leia o WhatsApp guia do conector.
Quando você configura o conector do WhatsApp, o conjunto de dados WhatsAppdo Evento Bruto do Webhook é criado automaticamente. Esse conjunto de dados é ativado automaticamente para o Perfil com dados não estruturados com as informações do canal também aplicadas.
Depois de configurar o conector WhatsApp, entre em contato com o Atendimento ao Cliente da Adobe com informações, incluindo a ID da organização, informações da sandbox, canal (WhatsApp Business) e o modo (streaming ou lote) para incluir na lista de permissões o conector a ser usado para o Perfil com dados não estruturados.
Para conversas no Brand Concierge, três conjuntos de dados que rastreiam o prompt do usuário, a resposta do agente e o feedback são criados automaticamente.
Para habilitar esses conjuntos de dados para o Perfil com dados não estruturados, é necessário fazer uma solicitação PATCH para o ponto de extremidade v2/dataSets e, ao mesmo tempo, fornecer a ID de cada um dos três conjuntos de dados.
| accordion | ||||
|---|---|---|---|---|
| Exemplo de solicitação e resposta de patch para habilitar o conjunto de dados para o Perfil com dados não estruturados. | ||||
Uma resposta bem-sucedida retorna o status HTTP 200 com a ID do conjunto de dados recém-atualizado.
|
Configurar o contexto do perfil
Depois de assimilar dados não estruturados na Experience Platform, você pode configurar o contexto do perfil para ajudar a personalizar suas conversas. Você pode configurar essa narrativa de perfil usando o Coworker ou as APIs do Experience Platform.
Você pode começar a configuração perguntando “Quero criar uma configuração de perfil semântico” no Coworker.
O parceiro guiará você pelas etapas para configurar o Perfil com dados não estruturados ao prosseguir com as seguintes etapas:
-
O colega de trabalho perguntará “Qual é o seu caso de uso”?
-
Depois de descrever seu caso de uso, o Colaborador fornecerá uma lista de atributos relevantes, com base no caso de uso
-
Depois que você confirmar que os atributos parecem bons, o Colaborador confirmará as seguintes ações. Por padrão, o Colaborador terá não descrições de público-alvo, precisa narrativa de perfil, não rótulos de governança de dados e o namespace de pessoa padrão.
- Se você quiser adicionar as descrições do público-alvo à narrativa de perfil
- A precisão da narrativa do perfil
- Adicionar rótulos de governança de dados e definir o namespace de pessoa
Depois de seguir essas etapas, seu Perfil com contexto de dados não estruturados é criado.
Você pode configurar o Perfil com contexto de dados não estruturados usando as APIs do Experience Platform.
Antes de continuar, leia o guia de introdução para obter links para a documentação relacionada, um guia para ler as chamadas de API de exemplo nesta seção e informações importantes sobre os cabeçalhos necessários para fazer chamadas com êxito para qualquer API Experience Platform.
Obter categorias get-categories
Primeiro, será necessário obter as categorias para o contexto do Perfil. As categorias são agrupamentos de atributos de perfil que estão disponíveis na sandbox.
Formato da API
| code language-http |
|---|
|
Solicitação
A solicitação a seguir recupera uma lista de todas as categorias disponíveis e seus atributos na sandbox.
| accordion | ||
|---|---|---|
| Uma solicitação de amostra para recuperar as categorias disponíveis. | ||
|
Resposta
Uma resposta bem-sucedida retorna o status HTTP 200 com uma lista das categorias disponíveis para sua organização e sandbox.
| accordion | ||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Um exemplo de resposta que contém uma lista das categorias e atributos que pertencem à sua organização e sandbox | ||||||||||||||||||||
|
Criar uma configuração
Depois de obter as categorias disponíveis para sua sandbox, você pode criar uma configuração. A configuração contém as categorias e os atributos dos dados do perfil, os públicos que você deseja destacar, as ações de marketing, a precisão da narrativa, bem como o namespace.
Formato da API
| code language-http |
|---|
|
Solicitação
A solicitação a seguir cria um Perfil com configuração de dados não estruturados, usando a categoria Demografia do cliente, incluindo um público especificado, nenhuma ação de marketing, precisão narrativa difusa e namespace de email.
| accordion | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Uma solicitação de amostra para criar uma configuração de perfil. | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|
Resposta
Uma resposta bem-sucedida retorna o status HTTP 200 com uma ID de solicitação exclusiva e os detalhes da configuração recém-criada.
| accordion | ||
|---|---|---|
| Um exemplo de resposta que contém a configuração recém-criada. | ||
|
Agora que o contexto do perfil foi criado, você pode salvar a configuração no Brand Concierge ou em qualquer outro agente voltado para o cliente.
Contexto de perfil no Brand Concierge profile-context-brand-concierge
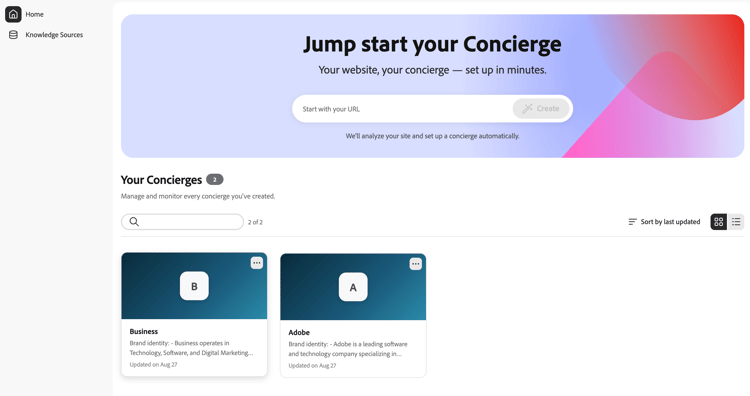
No Brand Concierge, selecione o concierge ao qual deseja aplicar a configuração do perfil.
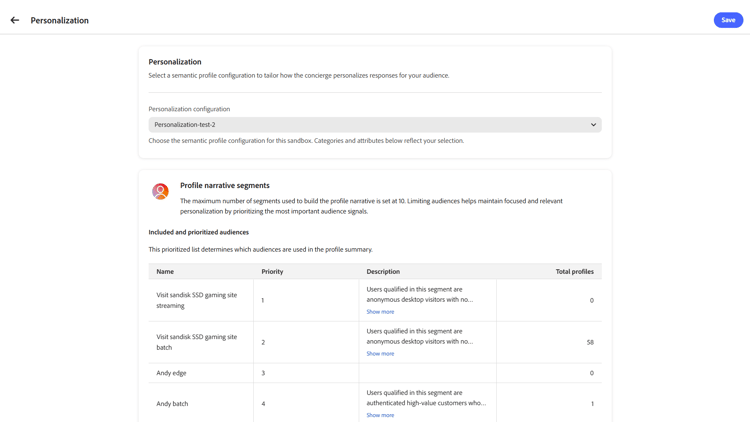
Após selecionar o concierge, vá para a guia Personalization e selecione a configuração criada anteriormente.
Contexto de perfil com outros agentes do cliente profile-context-other
Para usar o contexto de perfil com outros agentes voltados para o cliente, será necessário usar a API do Experience Platform para pesquisar o contexto de perfil do cliente e recuperar o histórico da conversa. Ao recuperar esses dois valores, o agente pode recuperar corretamente o contexto completo e relevante antes de iniciar uma conversa.
Para pesquisar o contexto do perfil do cliente, você precisará fazer uma solicitação GET para o ponto de extremidade /semanticprofile/lookup/narrative enquanto fornece os entityIdNS, entityId e configurationName como parâmetros de consulta.
| code language-shell |
|---|
|
| table 0-row-2 1-row-2 2-row-2 3-row-2 | |
|---|---|
| Parâmetros de consulta | Descrição |
entityIdNS |
O namespace de identidade. Deve ser um namespace definido em sua sandbox. Os valores possíveis incluem Email, ECID e CRMID. |
entityId |
O valor de identidade no namespace. Você deve codificar caracteres reservados em URLs. |
configurationName |
O nome da configuração criada anteriormente. |
Uma resposta bem-sucedida retorna o status HTTP 200 com informações sobre o contexto do perfil.
| code language-json |
|---|
|
| table 0-row-2 1-row-2 2-row-2 | |
|---|---|
| Campo | Descrição |
requestId |
A ID exclusiva gerada para a solicitação. |
narrative |
O resumo do perfil de linguagem natural gerado. |
Para pesquisar o histórico de conversa anterior de um cliente, será necessário fazer uma solicitação POST para o ponto de extremidade /semanticprofile/query/v1/profile, fornecendo entityIdNS e entityId como parâmetros de consulta.
| code language-shell |
|---|
|
| table 0-row-2 1-row-2 2-row-2 | |
|---|---|
| Parâmetros de consulta | Descrição |
entityIdNS |
O namespace de identidade. Deve ser um namespace definido em sua sandbox. Os valores possíveis incluem Email, ECID e CRMID. |
entityId |
O valor de identidade no namespace. Você deve codificar caracteres reservados em URLs. |
| Campo de solicitação | Tipo | Descrição |
| ------------- | -------- | ---- | ----------- |
| conversations | Objeto | Um objeto que determina que você deseja retornar informações sobre as conversas. Ao deixá-lo como um objeto vazio, você receberá automaticamente informações sobre as interações, metadados e sinais. |
Uma resposta de amostra retorna o status HTTP 200 com informações sobre as conversas da entidade solicitada.
| code language-json |
|---|
|
Depois de obter a narrativa e as conversas, você pode alimentar esses dados com seus agentes de IA de terceiros. Como resultado, o agente de IA terá informações sobre quem é o cliente, bem como informações sobre o que o cliente discutiu.
Configurar sinais para extrair dados configure-signals
Depois de configurar o contexto do perfil, você pode configurar sinais para extrair dados de seus dados não estruturados.
Você pode começar esse processo indo até o Colaborador e pedindo “Deixe-me extrair sinais das conversas”. O colega pergunta, então, que tipo de sinais você deseja detectar nas conversas.
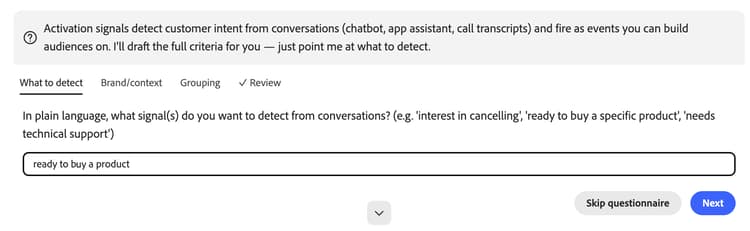
Em seguida, ele pergunta de que tipo de marca ou negócio essas conversas fazem parte.
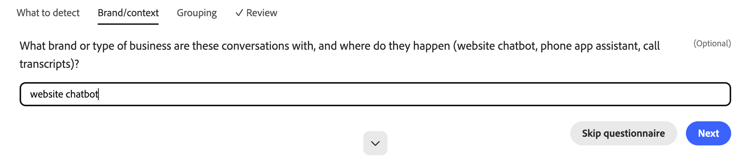
Finalmente, o Co-worker pergunta se você deseja criar um novo grupo de sinais ou se deseja adicionar a um grupo de sinais existente.
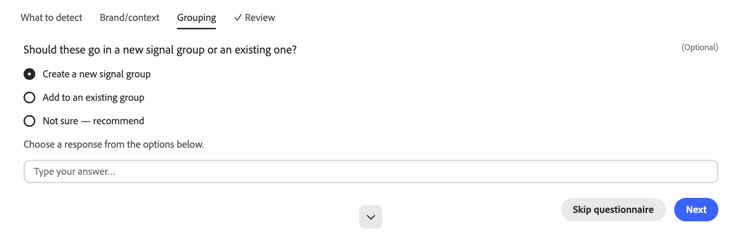
Você pode confirmar se as etapas acima parecem precisas e se deseja continuar com a criação do sinal.
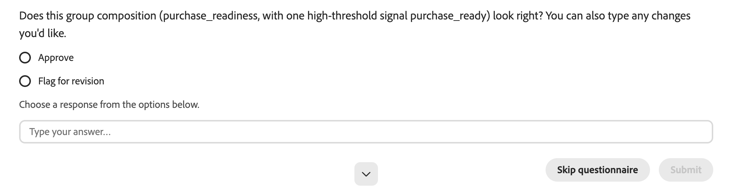
A criação do sinal é iniciada. O colega cria um sinal que é adicionado automaticamente ao Experience Platform.
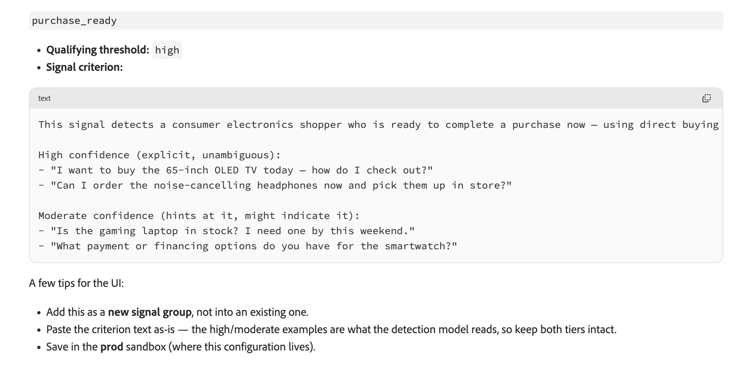
Perguntas frequentes faq
A seção a seguir lista as perguntas frequentes relacionadas aos perfis com dados não estruturados.
Os perfis com dados não estruturados são separados de um perfil de cliente normal?
Qual é o contexto do perfil/narrativa do perfil?
O contexto do perfil (narrativa do perfil) é a informação consolidada fornecida a um agente de IA para melhorar uma interação. O contexto pode combinar os seguintes dados:
- Atributos do perfil
- Associação de público-alvo
- História comportamental
- Atividade de navegação
- Conversas anteriores
O que é um sinal?
Um sinal é uma representação de significado estruturada e pronta para ativação que é detectada em uma interação não estruturada. Exemplos de sinais incluem:
- Interesse do produto
- Tentativa de cancelamento
- Uma preferência declarada
- Um evento de vida
- Uma experiência negativa
- Uma indústria
- Uma função de comprador
Os sinais podem ser definidos por profissionais de marketing ou criados pelo sistema ao analisar sinais individuais descobertos nos dados.
Como um sinal difere da conversa bruta?
O Perfil com dados não estruturados é compatível apenas com o Brand Concierge?
Quais fontes de dados posso usar?
As seguintes fontes são compatíveis:
- Conversas no Brand Concierge e em outros idiomas
- Conversações no WhatsApp
- Pesquisar consultas
- Transcrições da central de atendimento
- Logs de chat
- Pesquisas
- Transcrições de webinários e chamadas de vendas
- Outras interações baseadas em texto