Experience Platformの異常値の検出
Adobe CX Enterprise Coworker チャットを使用して、サポートされているAdobe Experience Platform指標の急増と減少を特定します。 データフローとオーディエンスを確認し、ベースラインからの偏差を特定します。
大まかな質問から始め、注意が必要なフローやオーディエンスに焦点を当てます。 何を調査するかを決める前に、報告された指標とそのベースラインを確認します。
利用可能な診断スキル
baseline-anomalies プラグインを使用して、異常値の検出、トレンドの比較、フローの正常性または現在のジョブ失敗の確認を行います。 プラグインは、デフォルトでCoworkerのExperience Platformとアプリの機能で設定されます。
必要な情報にもとづいて質問の種類を選択します。
トレンドサマリーは変化を記述しますが、その変化が異常かどうかを判断するものではありません。 スパイクまたはドロップの評価が必要な場合は、異常値の質問を使用します。
始める前に
プラグインはデフォルトで設定されています。 診断に関する質問を行う前にステータスを確認するには、次の手順に従います。
-
カスタマイズに移動します。
-
「プラグイン」を選択します。
-
baseline-anomaliesを開き、ステータスが Active であることを確認します。
確認したいサンドボックスと領域を特定します。 特定のリソースの場合、フロー、セグメント、宛先名または識別子の準備ができていること。
一般的なチャットの手順については、 チャットの基本を学ぶを参照してください。
異常値について質問
確認する領域またはリソースと、確認する期間を記述します。
次のプロンプト例をベースに作成します。 例の名前を組織の名前に置き換えます。
この大まかな質問は、データフローとオーディエンスの両方をチェックします。 応答で特定されたサンドボックスと期間を確認します。
異常値の結果の確認
報告された値と、影響を受けるリソースと期間のベースラインを比較します。 異常を確定済みの原因として扱うのではなく、その違いを利用して、さらに調査が必要なものを特定します。
例えば、取り込み入力レコードの減少は、ボリュームの変化を識別します。 この変化だけでは、なぜ記録が少なくなったのかは説明できない。
結果は、表または手書きの要約として表示できます。 テーブルは、高リスク およびMedium リスク の下で異常値をグループ化できます。

この例では、フローの異常値をリスクごとにグループ化し、実行数またはトレンド履歴を調査することを提案します。 リソースの名前と値が編集されます。
説明とリスクグループを確認します。 オーディエンスの異常値の場合、「高」は通常の値から大きく離れていることを示します。 Mediumは、明確だが適度な出発を示している。 HighおよびMediumの異常値のみが返されます。
ベースラインの履歴が変動しやすい場合、オーディエンスの結果からMediumの異常値が除外されます。 したがって、非常に変動する履歴を持つ返された異常値は、高リスク層を持ちます。
根本原因を特定するのではなく、リスク層を利用して調査の優先順位を付けます。
たとえば、1つの応答では、1~4の予想される範囲に対する10の入力レコードが、中程度のリスクスパイクとして識別されます。 通常のレベルは約1 レコードであるため、ベースラインに対する偏差は大きくなります。 絶対量は小さいままです。
過去の異常値を現在の問題として扱う前に、イベント時間を確認します。 過去24時間以外のイベントは、基礎となる状態が回復したかどうかを確認しません。
ベースラインと期待範囲
時間別の異常値比較では、過去14日間と同じ時間を使用します。 これは、典型的なパターンを時間ごとに説明しますが、より広範な季節性を考慮していません。
オーディエンスの異常値の場合、予測範囲は中央値に重点を置き、履歴数の変動に応じて広くなります。 計算された下限が負の場合、範囲では代わりに最小の履歴カウントが使用されます。 したがって、範囲は中央値よりも中央値より上に広がることができます。
予想される範囲を超える実際のプロファイル数はスパイクです。 範囲を下回るカウントはドロップされます。 プロファイルが通常存在する場合、カウントが0になると、高いリスクが低下します。
離脱したプロファイル数は、スパイク判定のみを生成します。 ドロップの異常値ではなく、通常どおりに処理される出口が少なくなります。
返された異常値はありません
リクエストされたオーディエンスおよび期間に対して、高またはMediumの異常値が返されなかったことが応答で報告される場合があります。
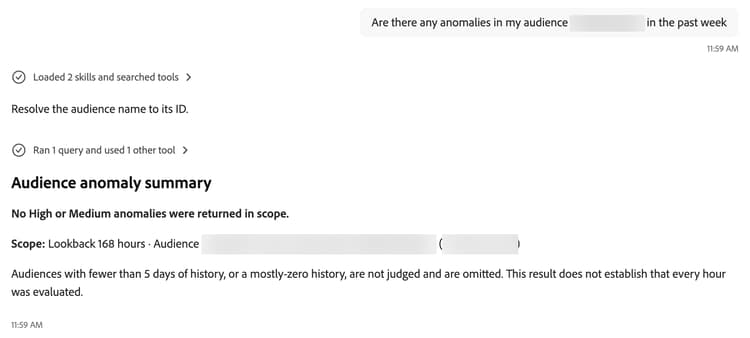
この例では、履歴が不十分または大部分がゼロであることを示す警告が含まれています。 すべての時間が評価されたか、このオーディエンスが除外されたかは確認されません。 オーディエンス名とIDが墨消しされます。
ベースライン履歴が不十分
ベースライン履歴は、オーディエンスを異常値で評価できるかどうかに影響します。
オーディエンスの異常値検出では、5日未満の履歴または履歴がほとんど0を含む行は評価されません。
質問を調整
次の質問は、影響を受けるリソースに集中してください。 たとえば、幅広い取り込みチェックの後、名前付きフローの異常について尋ねます。
過去24時間について質問した後、このフォローアップで期間を延長します。
What about in the past two weeks?
過去24時間以内に発生しなかった過去の異常値も応答で特定できます。
詳細な調査については、フローの実行数、フローの傾向、オーディエンスの傾向、現在失敗しているジョブなどについて問い合わせてください。 また、調査中に個々のジョブについて質問することもできます。
必要な情報にもとづいて次の質問を選びましょう。 トレンドと健全性の要約では、異常値の評決は提供されません。
オーディエンスの傾向履歴は、約2週間、つまり336時間にわたって保持されます。 典型的な値は、過去14日間のその時間の中央値です。
現在失敗したジョブの場合、空の結果は、リクエストされたスコープ内で現在失敗しているジョブがないことを意味します。 これは、要求された期間にエラーが発生しなかったという意味ではありません。 失敗した後に成功したジョブは除外されます。
ヘルスチェックスキルを使用して調査を継続するか、アラートスキルを使用して、サポートされているアセットのアラートを有効にします。 これらのアクションでは、異常値検出そのものではなく、個別のスキルを使用します。
関連するアラートワークフローについては、顧客アラートスキル を参照してください。
指標の参照
限定リリースには、取り込み、セグメンテーション、宛先アクティベーションに関する次の7つの指標が含まれています。 この参照を使用して、各領域に関連付けられているカウントを特定します。
input_record_countfailed_record_count__segment_{segment_id}__realized_profiles__segment_{segment_id}__exited_profiles{destination}_input_record_count{destination}_skipped_record_count{destination}_output_record_count範囲と制限
異常検知機能を利用して異常値を特定します。根本的な原因の確認やリソースの修復を目的としたものではありません。
名前または識別子を使用して、フロー、セグメント、宛先について質問できます。 フロー異常値検出では、取り込み、セグメンテーション、書き出し、宛先の各ステージに対応しています。
現在失敗しているジョブとその失敗理由に対して、失敗したジョブスキルを使用します。 復元されたエラーは除外されます。 ジョブ診断には、個々のレコードや異常値の判定の詳細は含まれません。
フローの正常性は、失敗の理由ではなく集計カウントを提供します。 トレンド概要は、異常値の判定ではなく、最近のデータと典型的な値を記述します。 オーディエンスのトレンドの要約は、バッチセグメンテーションのみを対象としています。
異常値検出は、データや設定を変更しません。 サポートされているアラートアクションとディープヘルス調査に対して、個別のスキルを使用します。