Adobe Experience PlatformデータをCoworkerで検証
Coworkerには、Experience Platform データセットのデータ品質をチェックするデータ検証スキルが含まれます。 単一の同僚チャット会話を通じて、データセットの統計的およびセマンティック検証の実行、データセットフィールドの分析、データ品質の問題の特定に使用できます。
データエンジニア、データ管理者、実装エンジニアは、SQL クエリや複雑なスキーマ階層を使用せずに、迅速な品質チェックにデータを使用します。
このスキルを使用して、以下を行います。
- 新しい実装または実装の更新後に、キーIDとイベントフィールドを検証します。
- フィールドの上位の値と無効な値を調べることで、マッピングの疑わしい問題を調査します。
- 重要なデータセットに対して継続的にデータスチュワードシップのチェックを実施し、リグレッションを早期に発見する。
始める前に
Coworkerでデータを検証するには、次のものが必要です。
- 検証するデータセットの名前またはID。
- (オプション)スキルでフィールドを自動的に選択しない場合は、検証する特定のフィールドの名前。
検証セッションを開始
-
Coworkerにログインします。
-
新規チャットを選択します。
-
テキストフィールドで、エージェントにフィールドまたはデータセットを検証するようにプロンプトを表示します。 次に例を示します。
プロンプト
データセット「Electronics Sample 1000」の検証
メッセージフィールドに「データセットの電子サンプル 1000を検証」というプロンプトが入力された
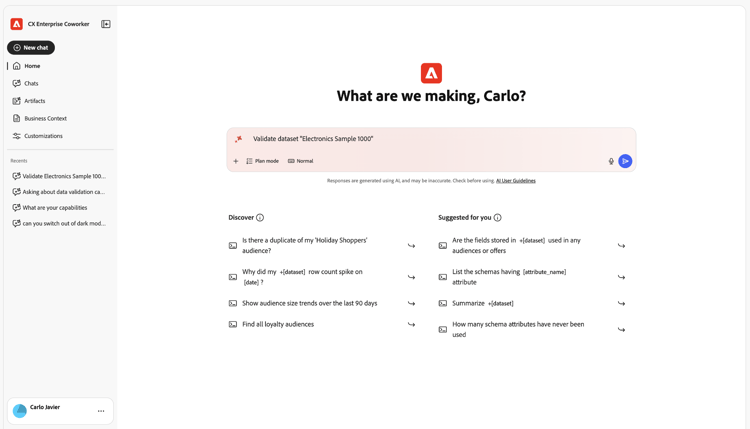
note tip TIP スキルが正しく識別できるように、データセット名の前に「データセット」という単語を付けます。 例えば、「Validate Electronics Sample 1000」の代わりに「Validate the dataset Electronics Sample 1000」を使用します。 リクエストはデータ検証スキルにルーティングされ、データセットのサンプルを分析し、同じ会話で結果を返します。
検証対象を選択
1つのフィールドまたはデータセット全体を検証できます。
データセット内の特定のフィールドを検証します。 このオプションには、次の機能があります。
- ヌルカウントと個別の値カウント。
- 上位の明確な値とその周波数。
- AIを活用したセマンティック検証により、フィールドのメタデータと実際の値にもとづいて、フィールドの期待される形式に一致しない値をフラグ付けします。
プロンプトの例:
- Customers_2024 データセットの電子メールフィールドを検証します。
- データセット customer_events_2024のフィールドステータスを検証します。
- 顧客データデータセットのフィールド person.address.cityを検証します。
データセット内の最大5つのフィールドを一度に検証できます。 フィールドを自分で指定することも、スキルにデータセットを分析させ、最も関連性の高いフィールドを自動的に選択させることもできます。 このオプションは、検証するすべてのフィールドで、フィールド検証と同じ情報を返します。
プロンプトの例:
- 顧客データ 2024年データセットを検証する。
- フィールドを検証する電子メール、Customers_2024の電話。
- 顧客データのfirstName、lastName、birthDateを要約します。
結果を見る
検証されたフィールドごとに、結果は次の列を持つテーブルの行として表示されます。
結果の下に、別のフィールドの検証やデータセットの再実行など、フォローアッププロンプトを提案する 次のステップ のリストが追加されます。
単一のフィールドを検証すると、Coworkerは次のチャートも返します。
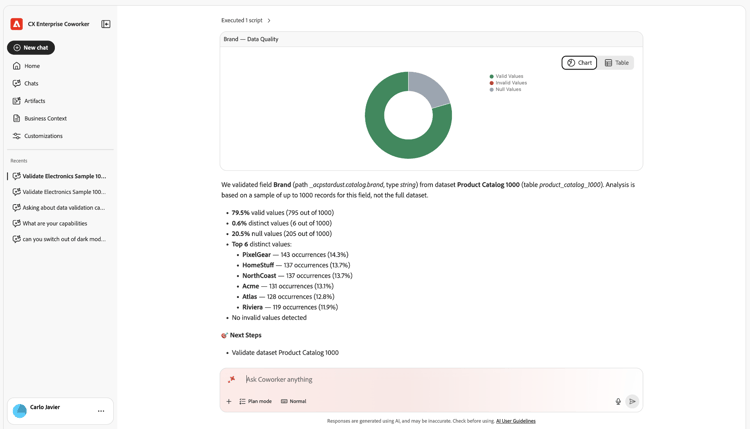
グラフまたは テーブル を選択して、同じ結果のビューを切り替えます。
データセットを検証すると、1つのフィールドに1行のテーブルに結果が表示されます。 自分の名前を付けたフィールドは、指定したフィールドと同じように表示されます。
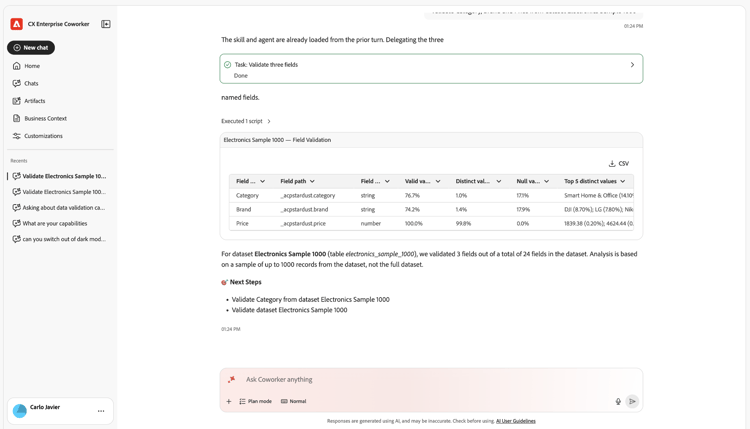
スキルが選択したフィールドは、自動的に同じように表示されます。
Electronics Sample 1000 データセットで自動的に選択された5つのフィールド(カテゴリ、ブランド、価格、在庫、条件)の検証結果を示す
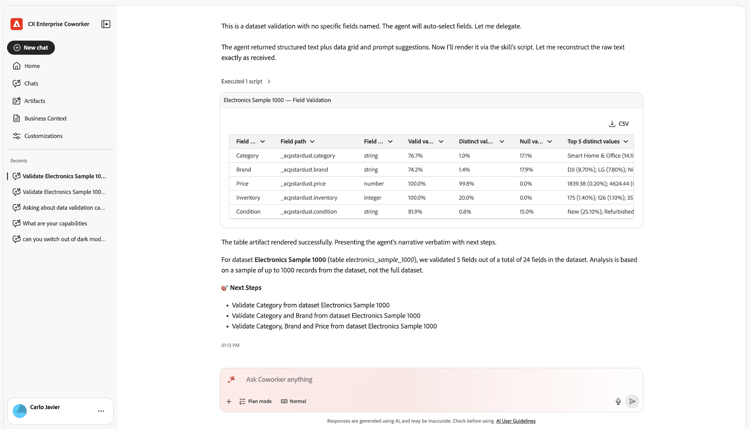
CSVを選択して、完全な結果テーブルをダウンロードします。
データ検証によるチェック
スキルは、各フィールドとデータセットに対して次のタイプのチェックを実行します。
-
完全性チェック:nullおよび欠落しているカウントとパーセンテージ。
-
分布チェック:上位の明確な値とその分布、および高い基数の検出。
-
スキーマに対するセマンティックチェック:XDM フィールド名、タイプ、説明を使用して、有効な値がどのように見えるかを推測し、異常をフラグします。
-
データタイプに応じたチェック (該当する場合):
- E メール:形式とドメインの可能性。
- 電話番号:形式の準備状況(例:E.164)。
- 日付とタイムスタンプ:基本的な形式チェック(ISO-8601など)。
これらのチェックは、決定論統計とLLM支援のセマンティック検証を組み合わせて、スキーマに技術的に一致する場合でも間違って見える値を検出します。
制限事項
データを検証する前に、次の制限事項を考慮してください。 これらの制約は、パフォーマンスと機能のバランスを取り、期待できる分析とインサイトに対する期待を設定します。
- サンプリングのみ: スキルは、データセット全体ではなく、データセットのサンプル(通常は最新の1,000行)を検証します。 完全なデータセットのスキャンは使用できません。
- フィールド数の制限: データセットを検証する場合、スキルは1 リクエストにつき最大5つのフィールドを分析します。 これらのフィールドを指定するか、スキルに自動的に選択させることができます。
- 確率的セマンティクス:無効な値の検出は、LLM ベースの推論に部分的に依存しており、一部では微妙なエラーが見落とされたり、境界値がフラグ付けされたりすることがあります。
- 読み取り専用: スキルはデータまたはそのスキーマを変更しません。 潜在的な問題をハイライト表示しますが、自動化された修正は実行しません。
検証のニーズがより詳細である場合や、複雑なビジネスロジックが必要な場合は、クエリサービスやデータ準備の検証などの追加ツールを使用して、これらの結果を補完します。
関連情報